Auteur
La rédaction DEV N SI
La rédaction DEV N SI documente la mise en œuvre de l’ingénierie logicielle et des systèmes d’information : architecture, API, DevOps, exploitation, sécurité applicative et incidents.
Architecture multi-agent : quand découper un agent complique le service
Des agents spécialisés peuvent clarifier un système, mais aussi multiplier les transferts, les coûts et les points de panne. Un cas fictif et des critères concrets pour décider où placer les frontières.
Context language models : décider quoi confier à la gestion du contexte
Avant d’évaluer un context language model, vérifiez si le contexte variable est bien la source du problème. Une méthode pour choisir un cas d’essai, définir les contrôles et décider si un pilote mérite d’être poursuivi.
React browser() : où accepter un rendu réservé au navigateur ?
Avant d’adopter browser() dans un projet React, partez de l’usage métier : que doit voir l’utilisateur sans attendre le navigateur, et quel contenu peut dépendre de celui-ci ? Un cas fictif et une grille aident à comparer les options, les risques et les critères de validation.
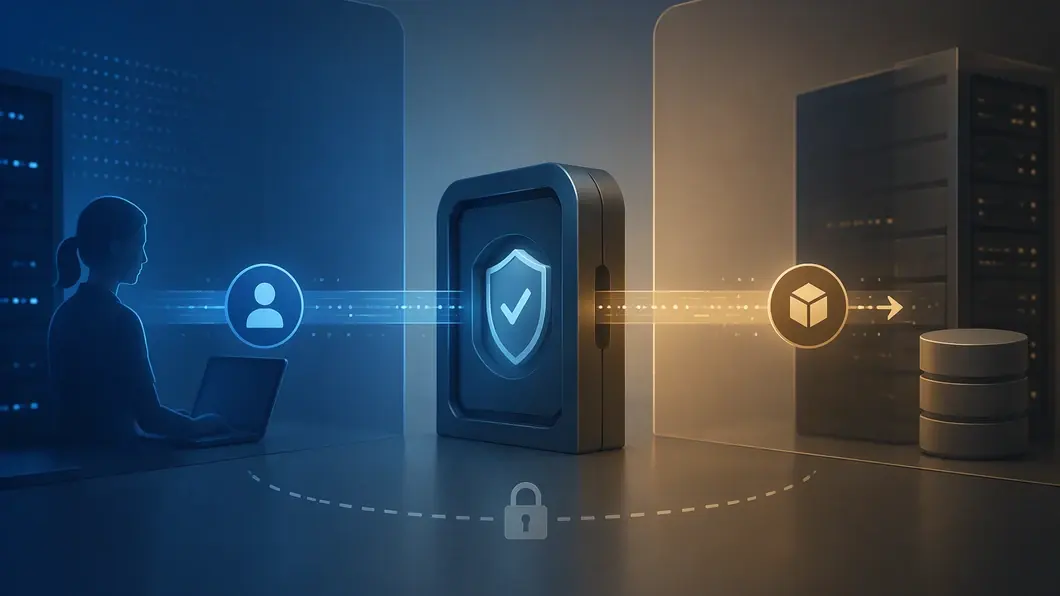
Cloudflare OHTTP Gateway : où placer la frontière de confiance ?
OHTTP vise à éviter que l’identité du client et le contenu d’une requête se retrouvent réunis au même endroit. Pour une équipe produit, l’enjeu est de vérifier cette séparation dans ses flux, ses responsabilités et ses scénarios de repli.
API asynchrones à l’échelle : décider quoi standardiser avant que les équipes se désynchronisent
Quand plusieurs équipes publient et consomment des événements, la difficulté est aussi organisationnelle que technique. Un arbre de décision pour choisir le niveau de gouvernance, les contrats et les livrables à prévoir.
Envoy Gateway 1.9.1 : décider d’une mise à niveau sans supposer ce qu’elle corrige
Envoy Gateway 1.9.1 est présenté comme une version de maintenance axée sur la sécurité, la fiabilité des mises à niveau et la correction opérationnelle. Voici comment évaluer son adoption sans extrapoler sur les changements précis.
GitLab auto-hébergé : décider quoi faire face à une faille exploitée
Une faille de traversée de chemin signalée comme activement exploitée concerne GitLab CE/EE auto-hébergé et pourrait permettre la lecture de fichiers sans authentification. Voici comment transformer ce signal en décisions vérifiables pour votre PME.
Plateforme interne en PME : le cas fictif qui aide à décider où investir
Une plateforme interne peut réduire les frictions récurrentes entre développement et exploitation, mais elle ajoute aussi un produit à maintenir. À partir d’un cas explicitement fictif, voici comment comparer les options et décider quoi construire en premier.
Code généré par IA : mesurer le coût après la génération
Les agents de codage peuvent accélérer la production, mais le temps de débogage et la compréhension du code comptent aussi. Voici comment une PME peut comparer ces coûts avant d’élargir leur usage.
Cœur de Famille : arbre généalogique ou souvenirs, quelle navigation choisir ?
Pour une application familiale mêlant généalogie et souvenirs, l’arbre et le fil chronologique ne répondent pas au même besoin. Comparez leurs usages, leurs limites et les critères à cadrer avant de choisir une navigation.
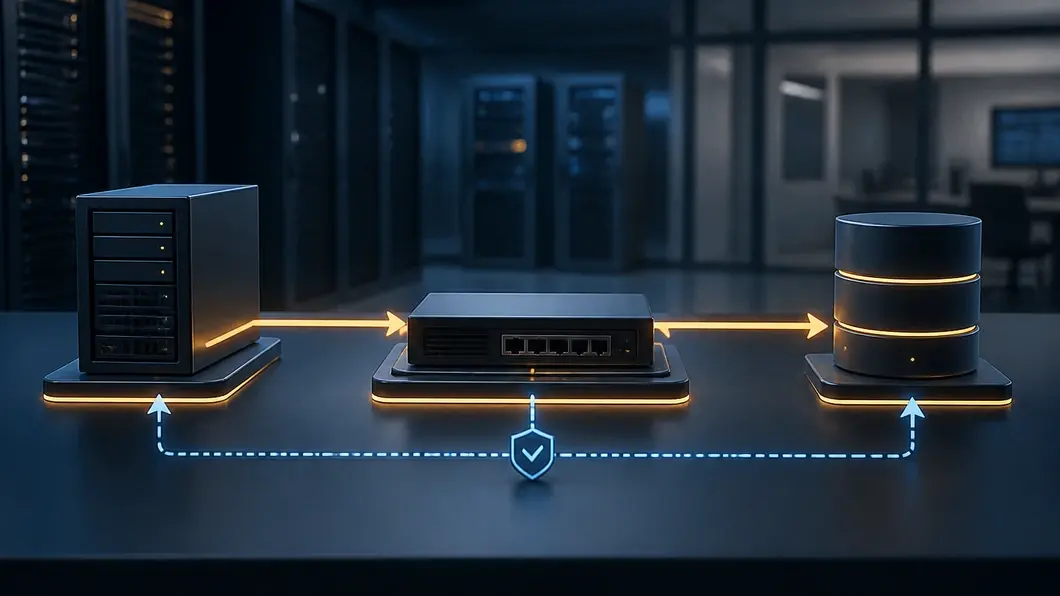
API critique : cadrer la continuité avant la première panne
Une API devient un sujet de continuité dès qu’un processus métier dépend de sa disponibilité. Cette méthode aide à définir le mode dégradé, les responsabilités, les contrôles réseau et les livrables à demander avant de confier le cadrage ou la réalisation à un prestataire.
Pizza Bot : une boîte de réception pour cadrer le travail des agents IA
Pizza Bot propose une interface de type boîte de réception pour des agents IA travaillant en arrière-plan. Pour une PME, l’enjeu est de déterminer quelles tâches lui confier, où garder la décision humaine et quels coûts ou risques vérifier avant un essai.
IA en production : qui valide une décision que le modèle peut changer ?
Une PME peut avoir testé un modèle sans avoir défini qui autorise ses changements en production. À partir d’un cas fictif, voici comment répartir les décisions, préparer une chronologie d’approbation et vérifier les preuves avant le lancement.
Équipe de développement et IA : comparer trois modèles avant de réorganiser
Les agents de codage changent la façon de produire du logiciel, mais pas la responsabilité de choisir quoi construire, de vérifier le résultat et de préserver la capacité de l’équipe à tenir dans la durée. Trois modèles pour aider une PME à arbitrer.
Tester un WAF avec l’IA : le protocole de décision avant tout essai
Cloudflare a décrit un harnais contrôlé où des modèles d’IA génèrent des variantes d’attaques bloquées par son WAF. Pour une PME, l’enjeu est de cadrer l’autorisation, les scénarios, les critères de réussite et les preuves avant d’envisager une démarche similaire.
Feature flags : préparer un mode dégradé fiable en production
Un feature flag peut faciliter une activation progressive, mais il devient un risque de continuité si son service de décision est indisponible. Voici les étapes pour définir un comportement de repli, tester la bascule et demander des livrables vérifiables.
Déploiement progressif : qui décide de poursuivre ou d’arrêter la mise en production ?
Un déploiement progressif ne réduit le risque que si l’entreprise sait qui autorise la suite, quels signaux surveiller et quand revenir en arrière. Cet arbre de décision aide à cadrer les droits, les contrôles et les livrables attendus d’un prestataire.
Continuité applicative : cadrer une migration technique progressive
Lorsqu’une application métier doit évoluer sans interrompre l’activité, le risque ne se limite pas à la bascule finale. Ce cas synthétique montre comment cadrer une période de coexistence, choisir les contrôles utiles et demander des livrables vérifiables avant de modifier le socle technique.
Refactorisation par agents : quelles preuves demander avant de confier son code à une IA ?
Une étude de cas évoque la refactorisation de 300 000 lignes de C en trois semaines avec des agents de codage. Pour une PME, l’enjeu n’est pas de reproduire ce chiffre, mais de vérifier ce que le harnais de validation, les métriques et les limites du périmètre permettent réellement de conclure.
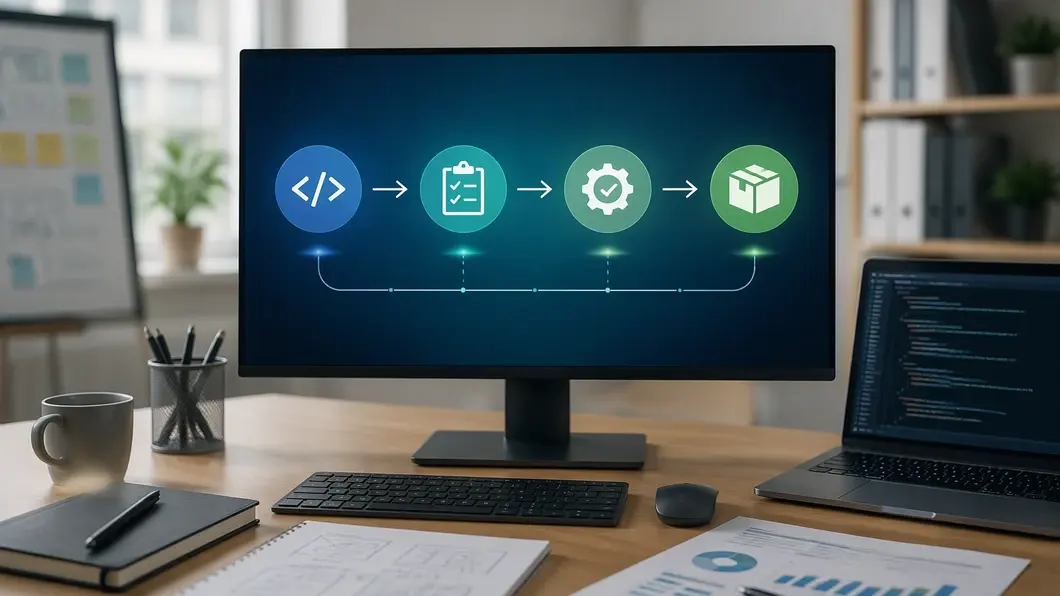
Outils de développement : construire une chaîne efficace sans empiler les logiciels
Un outil de développement n’est utile que s’il réduit un risque ou facilite une décision. Cette méthode aide une PME à composer une chaîne cohérente pour coder, tester, livrer et maintenir un logiciel sans multiplier les abonnements ni les dépendances invisibles.
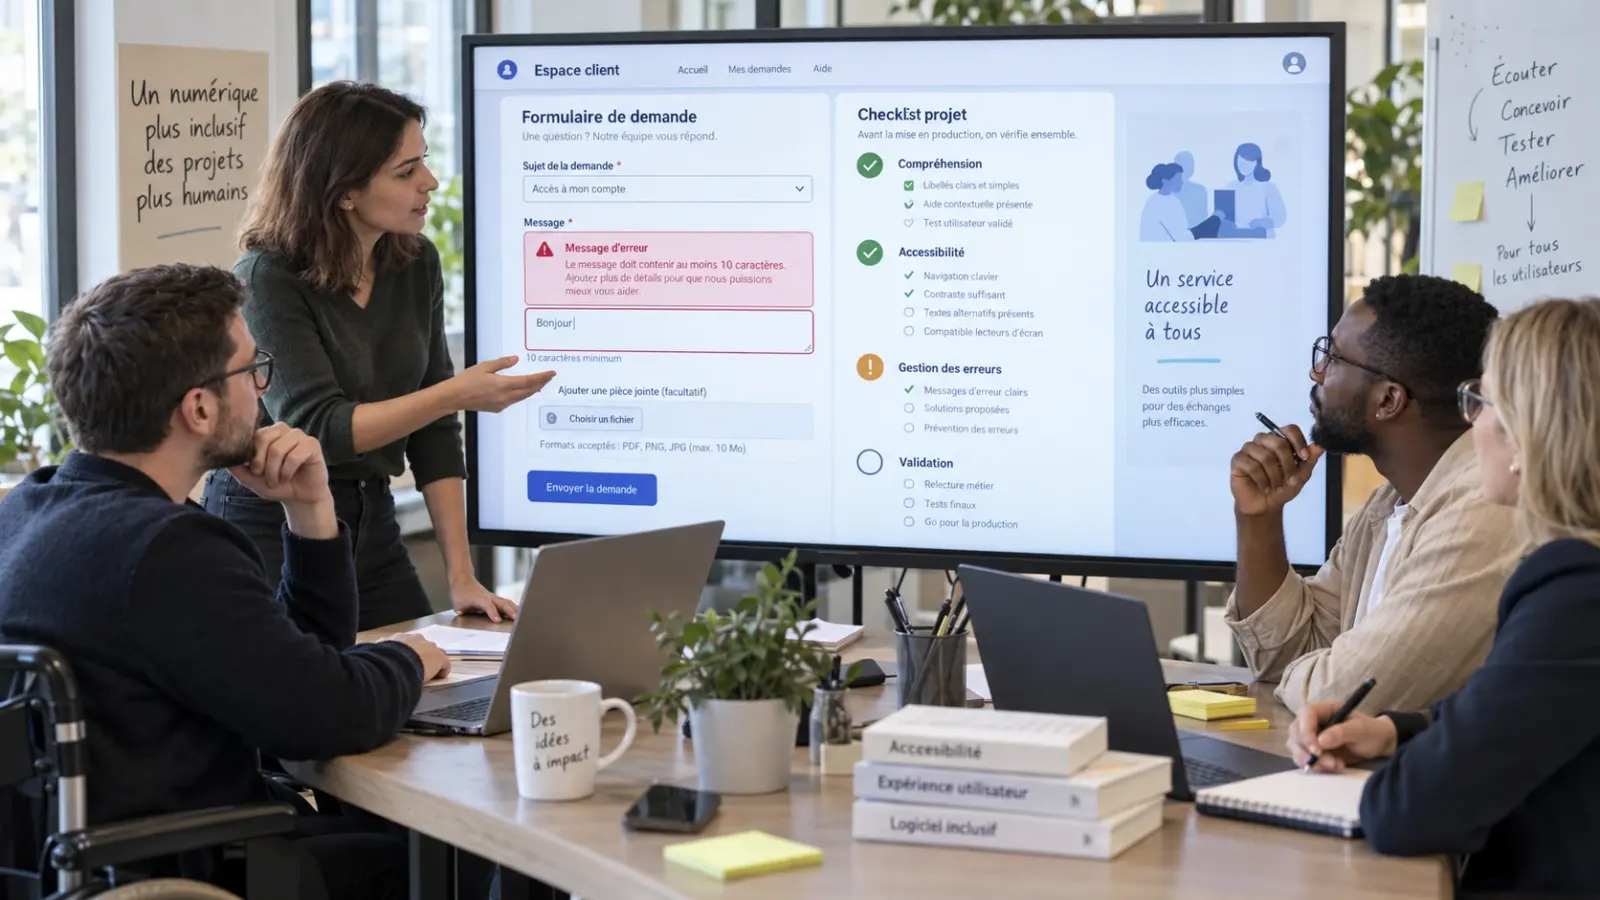
Paris Web 2026 : ce que l’inclusion change concrètement dans un projet numérique
Le compte rendu de Paris Web 2026 met en avant une ambiance ouverte, inclusive et bienveillante. Pour une PME, cette inspiration peut devenir une méthode de projet : écouter les usages, rendre les arbitrages visibles et vérifier l’accessibilité avant la mise en production.
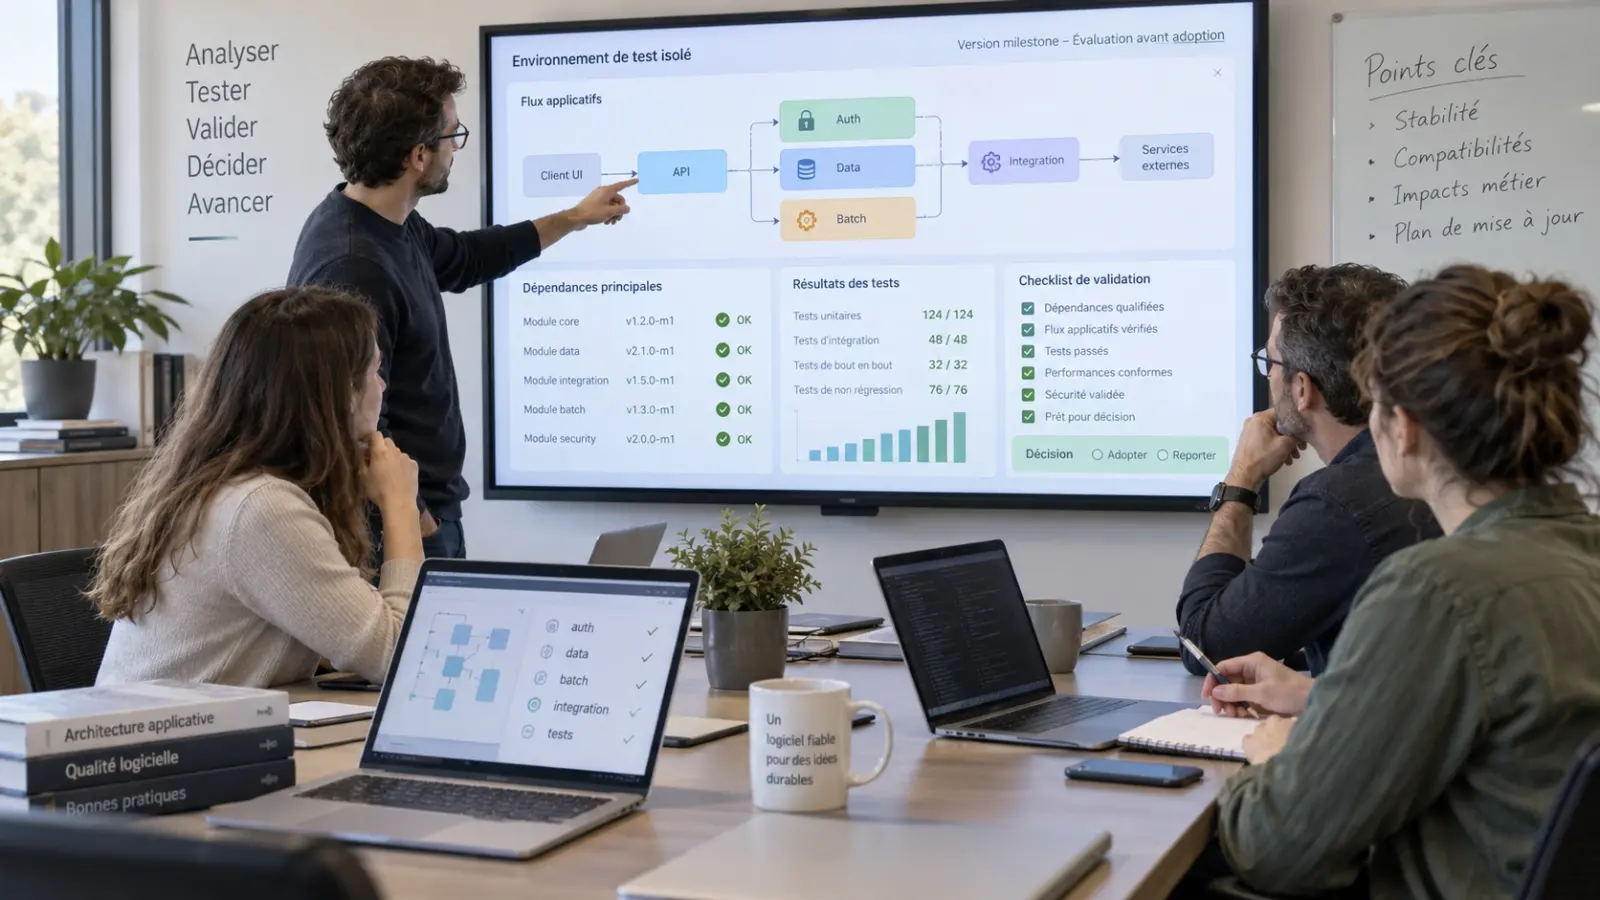
Spring en phase milestone : la méthode PME pour décider quoi vérifier avant d’adopter
Une vague de versions milestone Spring ne se résume pas à une liste d’annonces. À partir d’un cas fictif de PME, voici comment qualifier les dépendances, organiser les vérifications et décider ce qui mérite un essai avant une mise à jour.
De l’ingénierie plateforme au produit : décider si une idée technique mérite une entreprise
Passer d’un rôle de Staff Platform Engineer à celui de fondateur ne consiste pas seulement à changer de métier. Il faut traduire une intuition technique en problème client, tester le product-market fit, structurer un pitch vérifiable et décider si une plateforme interne peut devenir une offre.
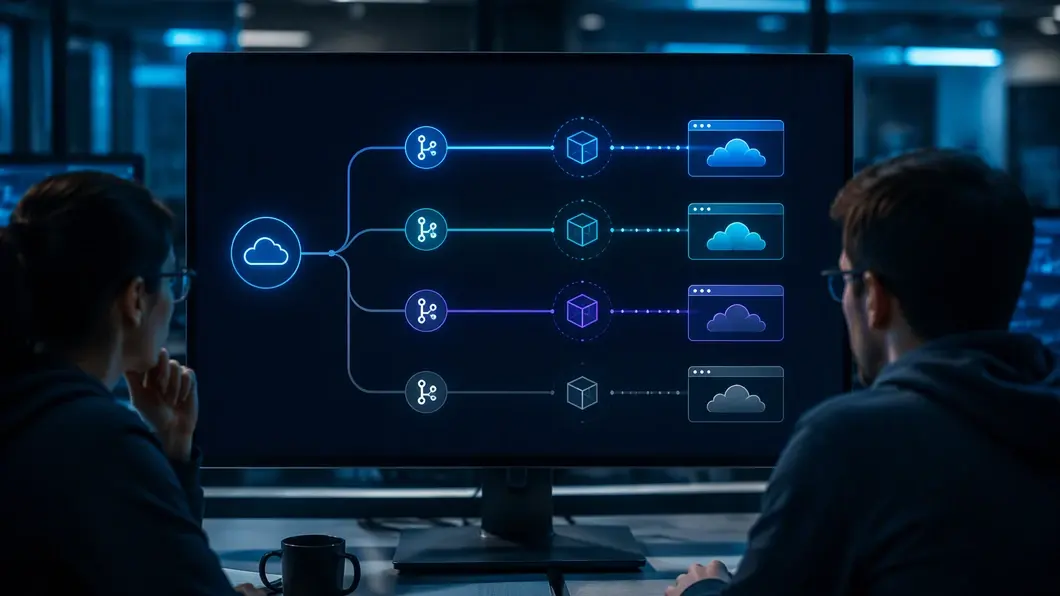
Cloudflare Worker Previews : choisir un environnement par branche sans perdre la maîtrise
Les Worker Previews de Cloudflare associent une branche Git à un environnement isolé, une URL stable, une configuration, un état et une observabilité propres. Voici comment évaluer cette approche avant de l’intégrer à un processus de validation applicative.
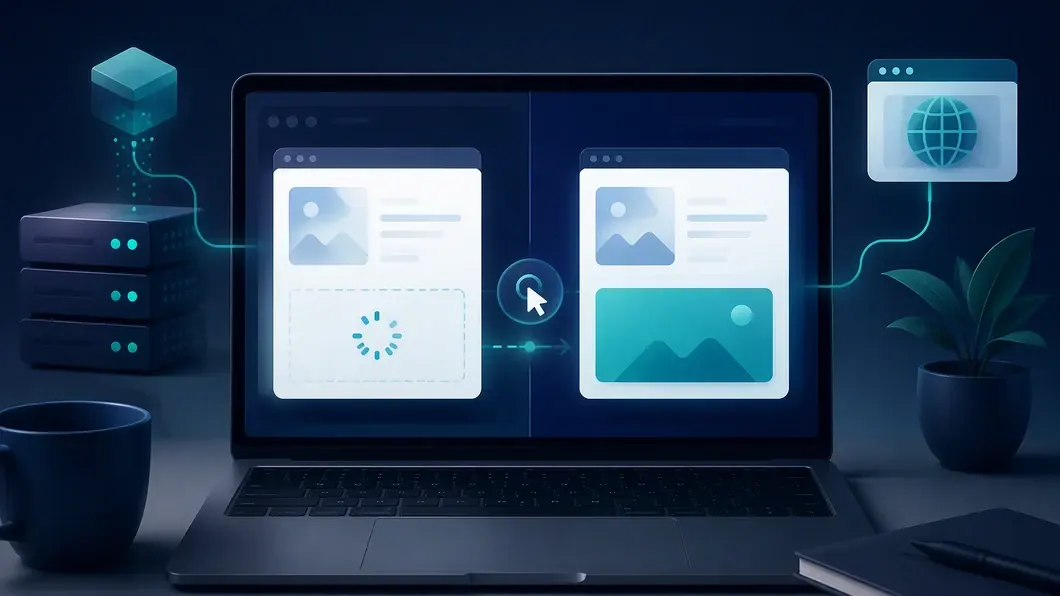
Nuxt : choisir entre Lazy et ClientOnly sans déplacer le problème
Lazy et ClientOnly répondent à deux décisions différentes dans Nuxt : retarder le chargement d’un composant ou réserver son rendu au navigateur. Cet arbre de décision aide à choisir la bonne optimisation sans dégrader l’expérience, le référencement ou la maintenabilité.
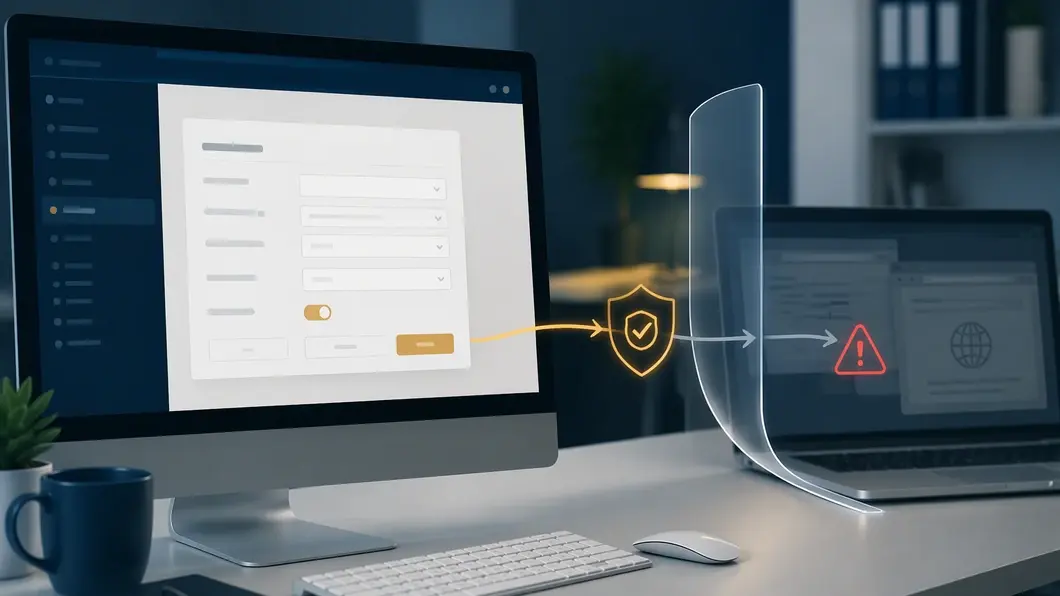
CSRF : comparer les protections avant de sécuriser une application métier
Une application métier qui utilise des cookies de session peut exécuter une action demandée depuis un autre site. Cette comparaison aide à choisir entre jeton CSRF, cookie double soumission, contrôle d’origine et règles SameSite, puis à vérifier la protection avant la mise en production.
Audit de maintenabilité applicative : comparer les preuves avant de reprendre un logiciel
Avant de reprendre une application, un audit de maintenabilité doit relier le code, l’exploitation, les dépendances et les journaux. Voici trois niveaux d’analyse, leurs livrables et les critères pour choisir une prestation proportionnée.
Feature flags et cybersécurité : les décisions à cadrer avant l’activation
Feature flags, droits applicatifs et traçabilité : une méthode de cadrage pour limiter les erreurs de déploiement, choisir les contrôles utiles et demander des livrables vérifiables à un prestataire.
Audit de sécurité applicative : quel niveau de preuve demander à un prestataire ?
Revue de code, analyse automatisée, modélisation des menaces ou test d’intrusion : un arbre de décision pour choisir le bon niveau d’audit de sécurité applicative et obtenir des livrables vérifiables.
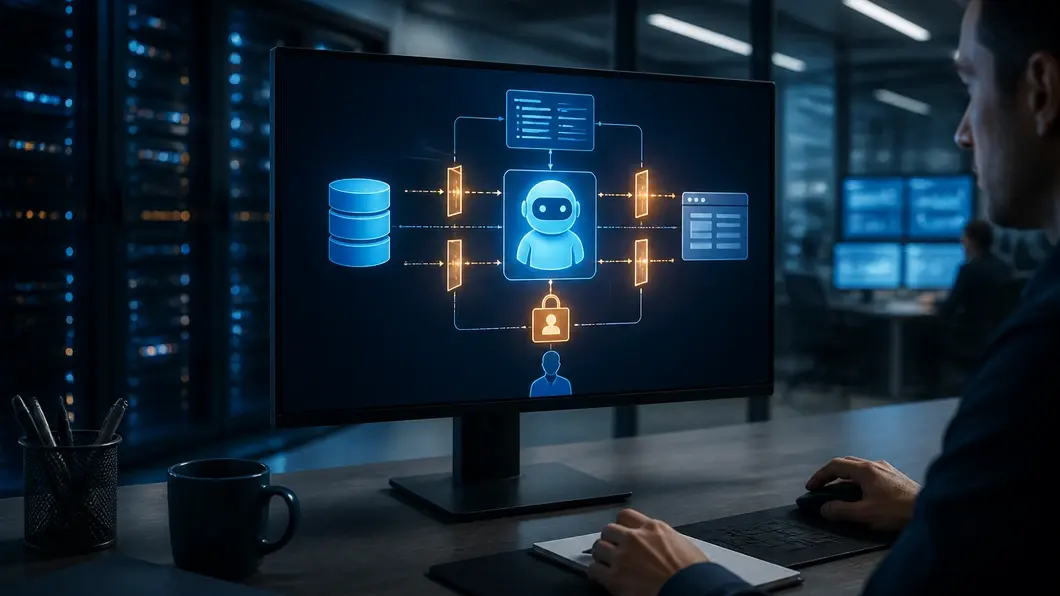
Agent IA en entreprise : comparer les garde-fous avant de lui ouvrir le SI
Un agent IA peut lire des données, appeler des outils et déclencher des actions dans le système d’information. Voici une méthode comparative pour choisir son niveau d’autonomie, limiter les droits et organiser une recette de sécurité vérifiable.
Shadow IT : le jour où un outil métier devient critique
Une étude de cas synthétique pour décider quoi faire lorsqu’un outil adopté hors du SI officiel devient indispensable : qualifier la dépendance, sécuriser la continuité, organiser la sortie et demander des preuves vérifiables.
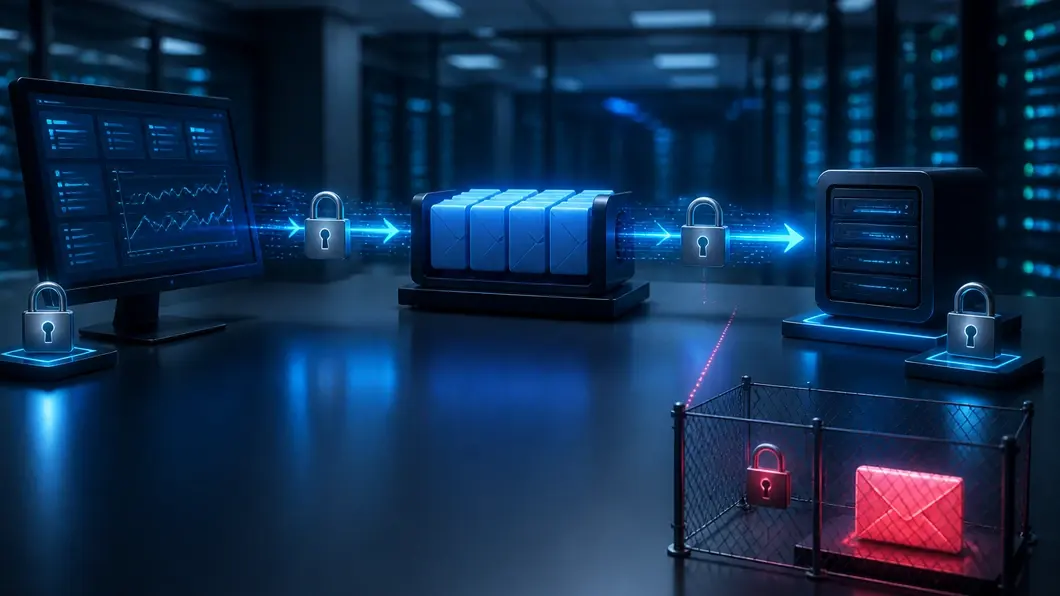
Traitements asynchrones : comparer les contrôles de cybersécurité avant le déploiement
Files de messages, workers et traitements différés élargissent la surface d’attaque d’une application. Cette comparaison aide à choisir les contrôles de cybersécurité à cadrer avant la mise en production, des droits au rejeu et à la surveillance des files.
Recette de non-régression : cadrer les tests avant une mise en production métier
Une méthode pragmatique pour préparer une recette de non-régression utile avant une mise en production : périmètre, scénarios critiques, responsabilités, preuves attendues et chronologie courte.
Cyber Resilience Act : décider si un projet logiciel doit changer de cadrage
Un arbre de décision pour savoir quand le Cyber Resilience Act doit modifier le cadrage d’un projet logiciel, les livrables à demander et les contrôles de sécurité à intégrer avant la recette.
Comité SI de PME : décider quoi moderniser quand tout semble prioritaire
Une étude de cas synthétique pour organiser un comité SI utile en PME : partir des irritants métier, qualifier les dépendances, arbitrer les chantiers numériques et demander des livrables vérifiables au prestataire.
Observabilité et identités : trois façons de retrouver qui a agi
Comparer journaux d’identité, traces enrichies et corrélation DevOps pour relier un incident applicatif à l’acteur humain ou technique, avec des livrables vérifiables et une minimisation des données personnelles.
Automatiser l’extinction cloud : scheduler, tags ou plateforme FinOps ?
Un comparatif opérationnel pour choisir comment automatiser l’extinction des ressources cloud non permanentes sans casser les tests, les traitements planifiés ni la responsabilité budgétaire.
Hébergement cloud d’une application métier : VM, PaaS ou conteneurs ?
Un comparatif opérationnel pour choisir le mode d’hébergement cloud d’une application métier selon les coûts visibles, l’effort de migration, l’exploitation, les dépendances et les marges d’optimisation FinOps.
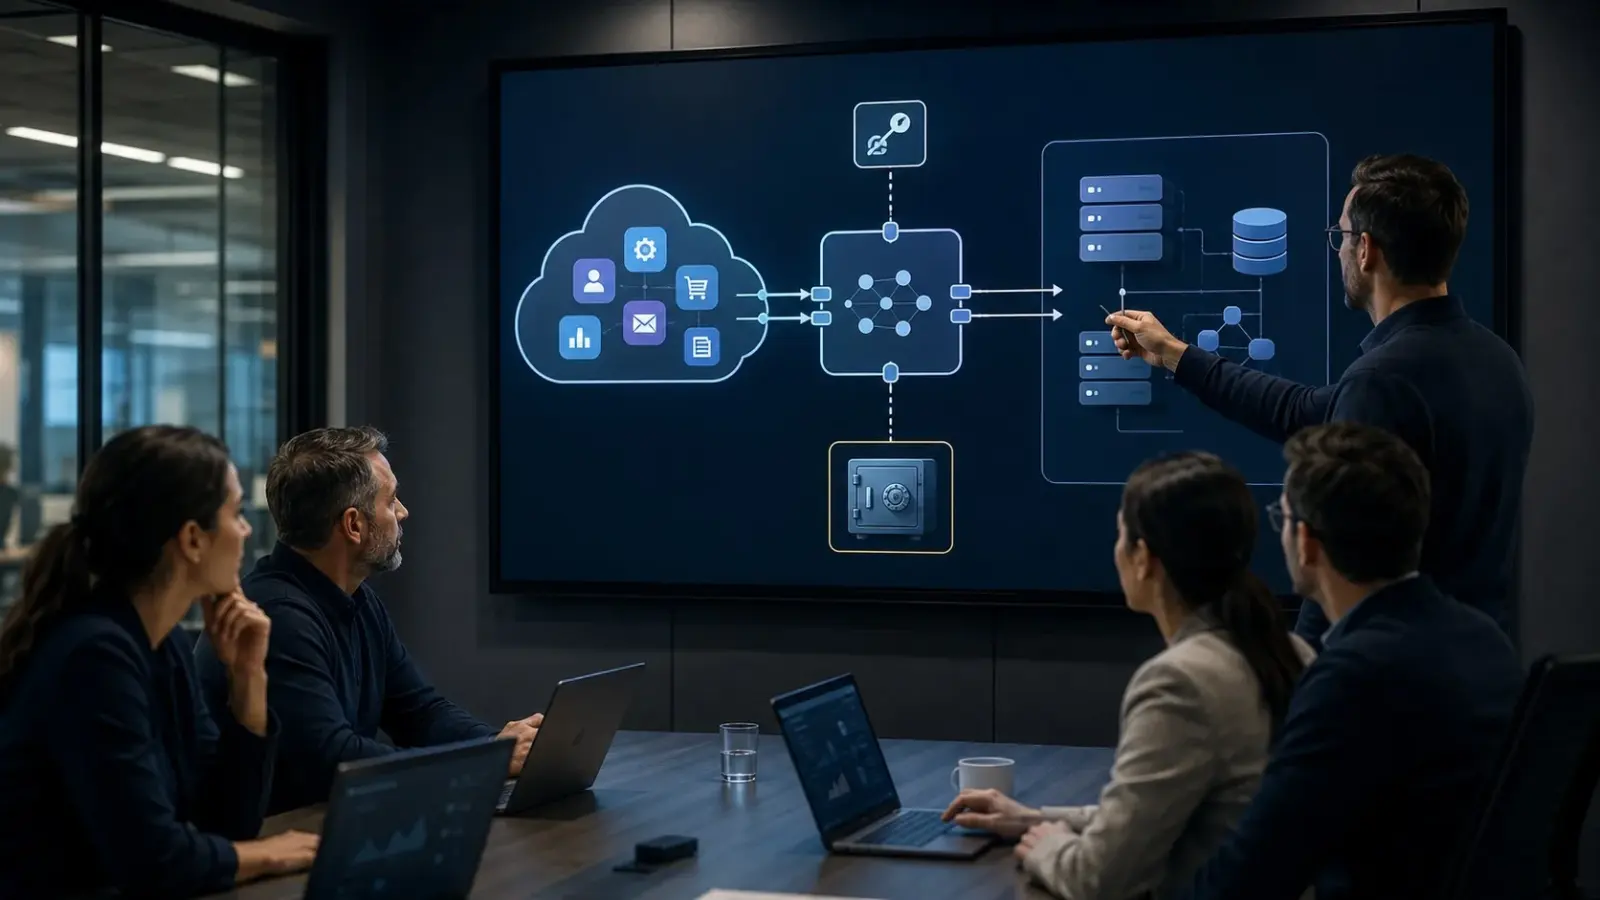
Connecteur SaaS et secrets : quelle architecture valider avant le déploiement ?
Un comparatif pour choisir comment un connecteur SaaS doit accéder aux secrets applicatifs avant son déploiement : stockage direct, coffre central, jeton limité ou relais interne.
Validation de connecteur applicatif : bac à sable, recette bout en bout ou pilote contrôlé ?
Un comparatif opérationnel pour choisir le bon dispositif de validation d’un connecteur applicatif selon le niveau de risque, les données échangées, les dépendances SI et le degré d’automatisation attendu.
Sécuriser les flux API : reverse proxy, API gateway ou service mesh ?
Un comparatif opérationnel pour choisir où placer les contrôles de sécurité des flux API entre reverse proxy, API gateway et service mesh, sans alourdir inutilement le réseau ni les coûts d’exploitation.
Valider un connecteur SI : matrice de choix avant intégration
Une matrice de comparaison pour choisir comment valider un connecteur SI avant de l’intégrer durablement : contrat, données, erreurs, sécurité, exploitation et preuve de décision.
Décommissionnement applicatif : fermer un service sans laisser de traces dangereuses
Une méthode concrète pour arrêter une application, archiver ce qui doit l’être, couper les accès et supprimer les dépendances résiduelles sans créer de risque caché.
Mise en production sensible : préparer le jour J sans découvrir les risques en direct
Un guide par étapes, nourri d’un retour d’expérience, pour préparer une mise en production sensible avec un plan de bascule, des critères de décision, une chronologie courte et une checklist exploitable.
Environnements éphémères : tester vite sans empiler les plateformes oubliées
Questions-réponses pour décider quand créer des environnements éphémères, comment les limiter dans le temps et quels garde-fous installer avant qu’ils ne deviennent une nouvelle dette d’exploitation.
Feature flags : livrer progressivement sans transformer le code en labyrinthe
Un comparatif pragmatique pour choisir entre branche longue, paramètre de configuration et feature flag, puis organiser le cycle de vie des bascules sans perdre la maîtrise du produit.
Traitements asynchrones : décider ce qui doit pouvoir être rejoué
Un arbre de décision pour concevoir des traitements asynchrones fiables : reprise, idempotence, files d’attente, erreurs et contrôles avant mise en production.
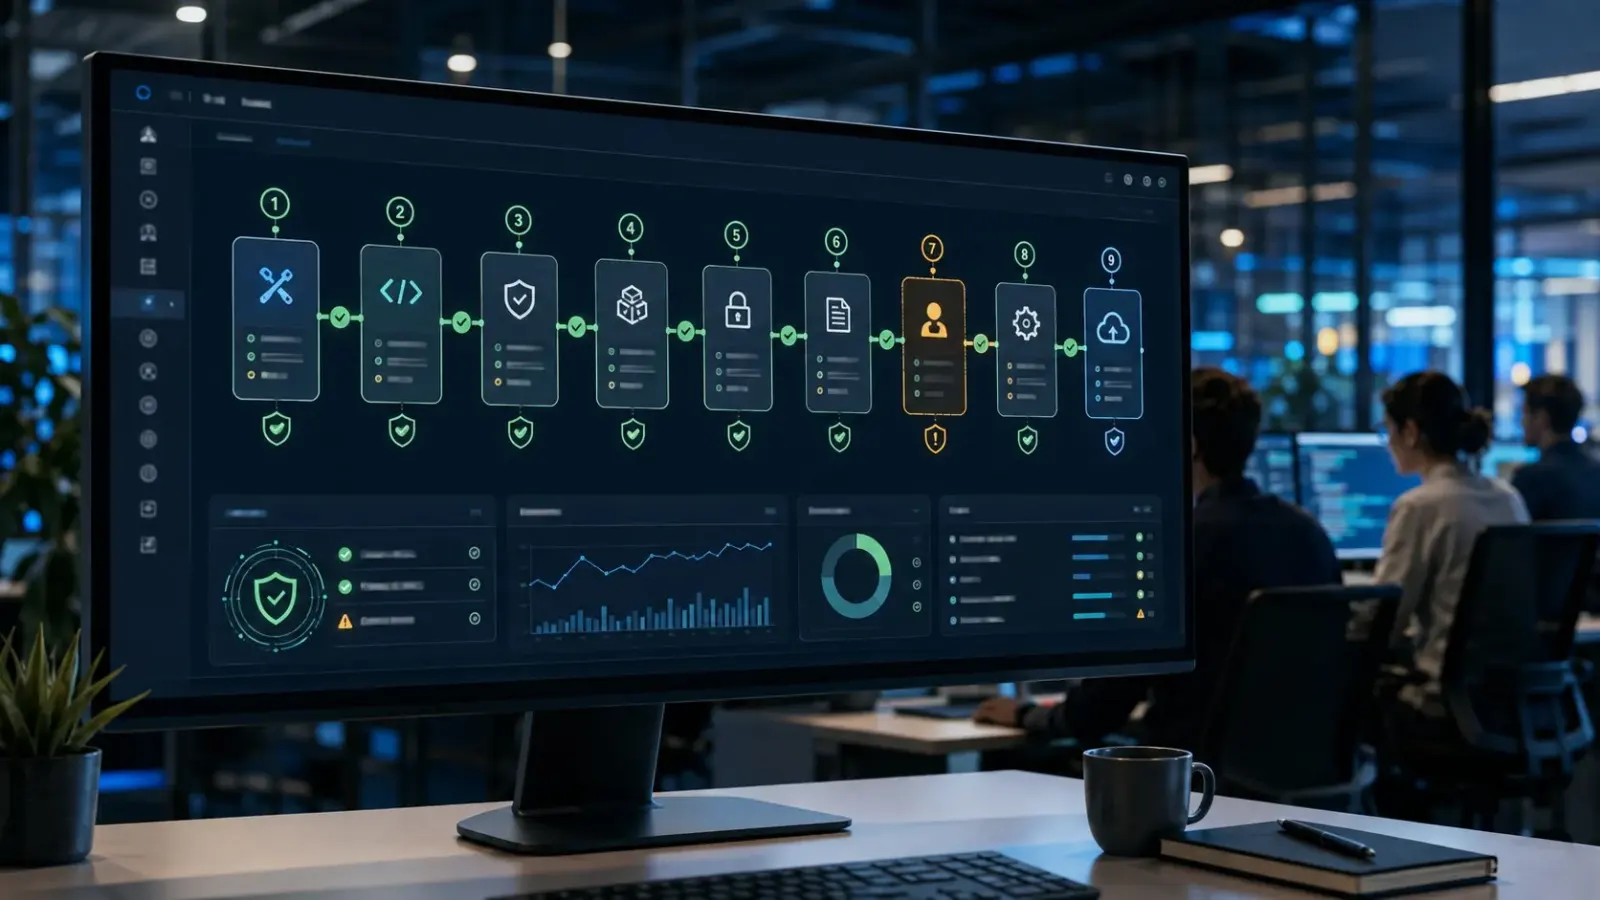
Pipeline CI/CD sécurisé : 9 contrôles à placer avant la production
Une liste commentée pour choisir les contrôles de sécurité utiles dans un pipeline CI/CD, les placer au bon moment et éviter qu’ils deviennent un frein aux livraisons applicatives.
Shadow IT : 8 contrôles avant de raccorder un outil métier au SI
Une liste de contrôles concrets pour sécuriser un outil de shadow IT lorsqu’il commence à échanger des données, créer des comptes ou dépendre du système d’information.
Logs de données : 8 traces à prévoir avant un traitement différé ou un feature flag
Une liste opérationnelle des logs de données à prévoir pour comprendre ce qu’un traitement différé ou un feature flag a réellement changé, sans dépendre d’une enquête improvisée après coup.
Droits applicatifs : 9 décisions à cadrer avant la recette
Une liste opérationnelle pour cadrer les droits applicatifs pendant le projet : rôles, profils sensibles, délégations, tests, support et décisions à verrouiller avant la recette.
Revue des droits applicatifs : le cas d’un accès oublié devenu risque projet
Une étude de cas pour organiser une revue des droits applicatifs utile, lisible et proportionnée, sans la transformer en rituel administratif déconnecté du terrain.
Journalisation applicative : reconstruire une erreur sans exposer les données
Une chronologie d’enquête pour concevoir des logs applicatifs utiles au diagnostic, à l’exploitation et à la sécurité sans transformer les traces en risque inutile.
Secrets applicatifs : organiser leur gestion avant la fuite
Une méthode par étapes pour inventorier, stocker, limiter et renouveler les secrets applicatifs sans bloquer les équipes de développement ni l’exploitation.
Shadow IT : passer de l’interdiction au catalogue SaaS encadré
Une méthode comparative pour réduire le shadow IT sans ralentir les métiers : arbitrer entre blocage, tolérance contrôlée et catalogue SaaS gouverné.
Registre des dépendances SI : préparer les changements avant qu’ils ne cassent ailleurs
Un guide en étapes pour construire un registre des dépendances SI exploitable avant une migration, une automatisation ou un changement d’architecture.
Secrets applicatifs : arrêter la dispersion avant la fuite
Une méthode concrète pour reprendre le contrôle des mots de passe, clés API, jetons et certificats utilisés par les applications sans bloquer les livraisons.
Données de test : choisir entre copie de production, anonymisation et synthèse
Un comparatif opérationnel pour préparer des données de test utiles sans exposer inutilement les données de production ni bloquer les équipes projet.
Décisions d’architecture : documenter sans ralentir l’équipe
Un arbre de décision pour savoir quelles décisions techniques documenter, sous quel format et comment les garder utiles pendant la vie du projet.
Agent IA ou automatisation classique : comment choisir ?
Une grille de décision pour choisir entre règles, workflow, intégration API et agent IA sans surdimensionner la solution.
Runbook d’incident : écrire le guide que l’équipe utilisera vraiment
Comment transformer la connaissance dispersée en procédures d’incident courtes, testables et réellement utilisables sous pression.
Réversibilité : vérifier qu’un logiciel ne retient pas vos données
Les contrôles à mener avant de choisir un SaaS pour pouvoir récupérer les données, les preuves et les flux sans projet d’urgence.
Phishing : préparer l’entreprise avant le premier clic
Une méthode concrète pour réduire le risque de phishing sans faire reposer toute la sécurité sur la vigilance individuelle.
Moderniser une application métier sans interrompre l’activité
Une trajectoire progressive pour remplacer une application vieillissante tout en maîtrisant les données, les interfaces et le risque opérationnel.
Comment rédiger un cahier des charges informatique utile
Une méthode concrète pour cadrer un projet informatique, prioriser les besoins et définir des critères d’acceptation sans imposer trop tôt la solution.
Facturation électronique : préparer son système d’information
Calendrier 2026-2027, données, plateforme agréée, flux et tests : les étapes pour préparer concrètement une entreprise à la facturation électronique.
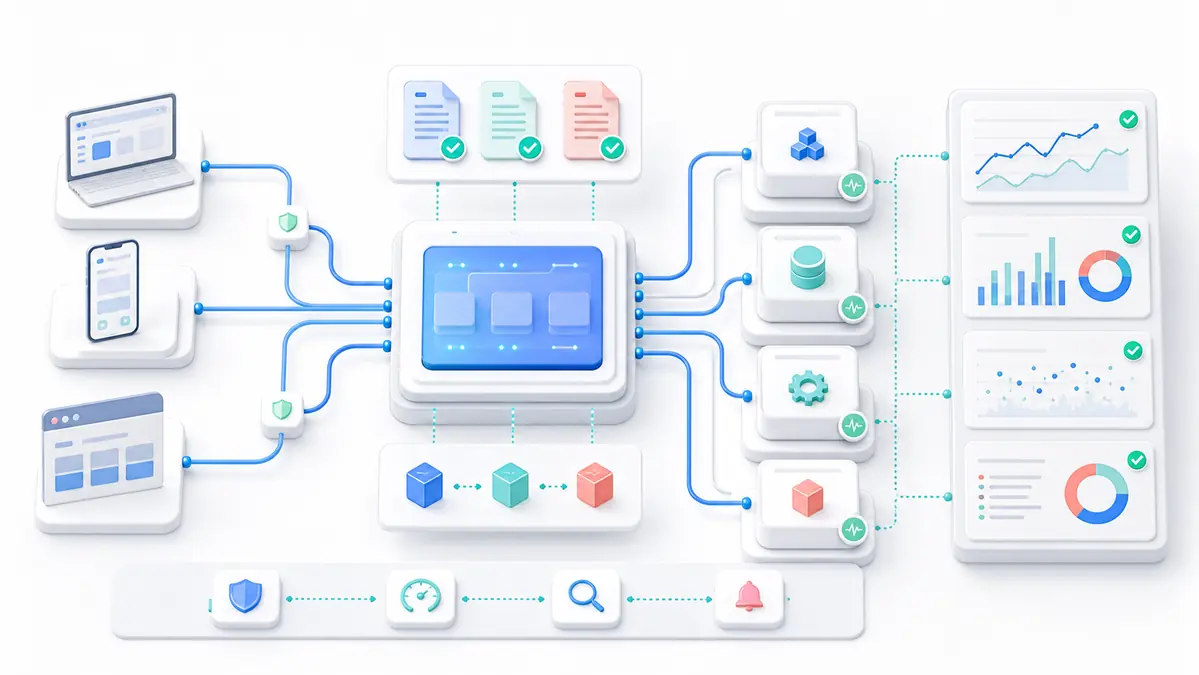
API maintenable : contrats, versionnement et observabilité
Les pratiques qui permettent de faire évoluer une API en production sans casser ses clients : contrat, compatibilité, erreurs, sécurité et observabilité.
Maîtriser les coûts cloud avec une démarche FinOps adaptée aux PME
Une méthode FinOps accessible pour attribuer les dépenses cloud, supprimer le gaspillage et relier chaque coût à la valeur du service.
Supervision informatique : transformer les alertes en décisions utiles
Comment construire une supervision informatique qui détecte les incidents importants, limite le bruit et guide l’équipe vers la bonne action.
MFA : protéger les comptes sans bloquer les équipes
Une méthode progressive pour déployer l’authentification multifacteur, choisir les bons facteurs et sécuriser la récupération des comptes.
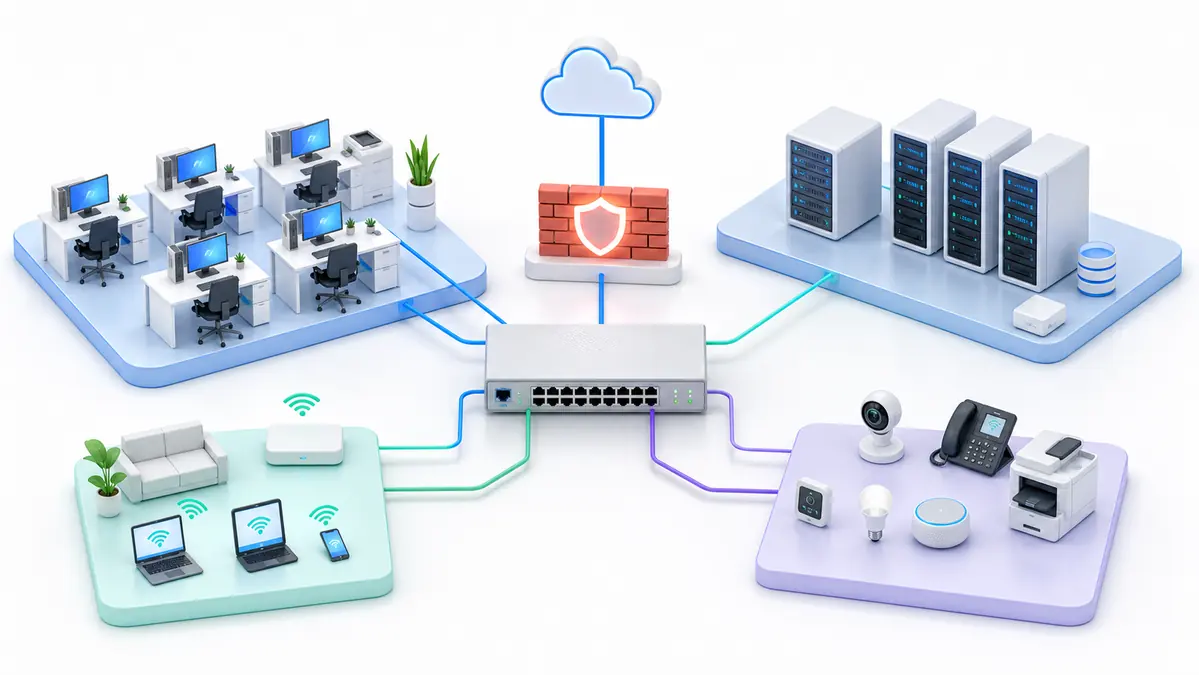
Comment segmenter le réseau d’une PME sans le complexifier
Une méthode progressive pour créer des VLAN et des règles lisibles, isoler les usages sensibles et limiter les mouvements d’un attaquant.
7 signes qu’une infrastructure informatique a besoin d’un audit
Alertes ignorées, accès obsolètes, sauvegardes non testées : sept signaux concrets qu’un audit informatique devient nécessaire.
Projet IA en entreprise : commencer par le problème métier
Une méthode pragmatique pour choisir un cas d’usage IA mesurable, tester les données et garder un contrôle humain avant d’industrialiser.
Sauvegarde et plan de reprise : pourquoi il faut tester la restauration
Une sauvegarde ne garantit pas la reprise d’activité. Découvrez comment définir RPO, RTO, dépendances et tests de restauration réellement utiles.