Un agent IA peut échouer sans faire tomber le service. Une traduction text-to-SQL peut confondre deux significations métier d’un même terme ; un changement de modèle d’embedding peut déplacer les seuils de décision alors que les contrôles d’infrastructure restent au vert. Pour un dirigeant de PME ou un responsable IT, surveiller uniquement la disponibilité ne suffit donc pas : il faut aussi vérifier le sens des résultats, la qualité des évaluations et les droits accordés à l’agent.
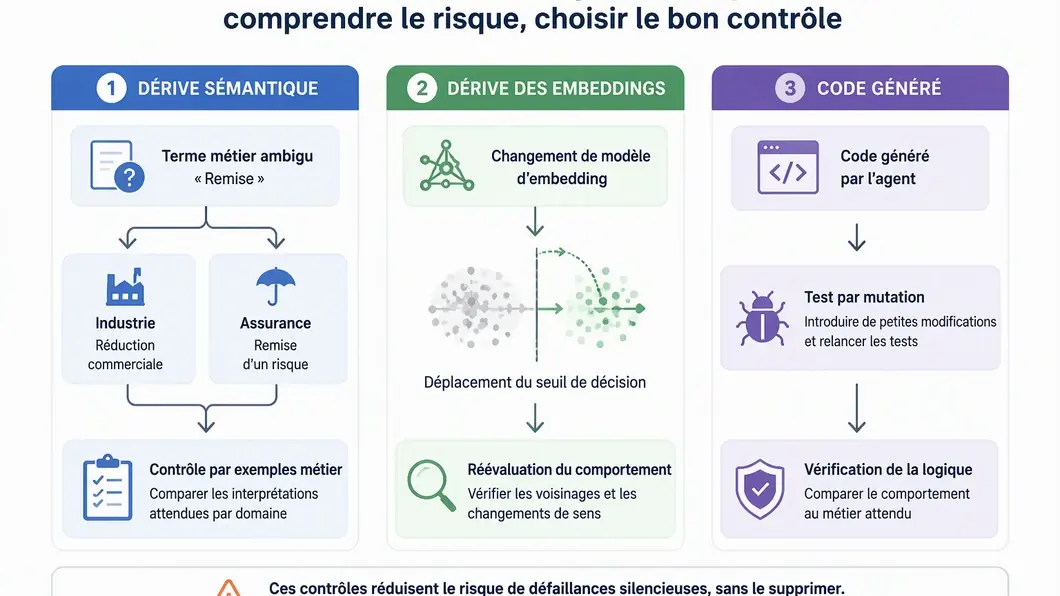
Ces risques ont été discutés lors d’un webinaire dont InfoQ a publié un compte rendu le 16 octobre 2026. Les cas rapportés permettent de distinguer trois problèmes que des contrôles différents doivent traiter : la dérive du résultat métier, l’évolution du comportement du modèle et l’autonomie trop large de l’agent.
Trois défaillances, trois angles de contrôle
Dans un pipeline text-to-SQL, le « semantic drift » décrit une perte de sens métier : le terme « membre » peut être interprété de la même manière dans les domaines ventes et support, alors que leur définition diffère. Le résultat peut sembler techniquement valide et échapper à une trace standard, tout en faussant l’analyse produite. Le point faible n’est alors pas nécessairement une panne ou une erreur de syntaxe ; c’est l’écart entre la requête générée et la définition métier attendue.
Un autre cas rapporté concerne l’« embedding drift » : une mise à jour en arrière-plan du modèle d’embedding a déplacé la distribution des distances vectorielles utilisées pour bloquer des conseils d’investissement interdits.
Le récit indique que des faux positifs et des faux négatifs ont fortement augmenté en trafic réel, alors que les vérifications de santé de l’infrastructure restaient au vert. Ce cas illustre une distinction importante : un service peut fonctionner techniquement sans que sa logique de décision reste stable.
Le troisième risque apparaît quand l’agent produit ou exécute davantage d’actions que l’équipe ne peut en contrôler manuellement. Le compte rendu relève le goulot d’étranglement des revues de code ligne par ligne face au volume de code généré.
Il rapporte aussi des risques de récupération de documents sensibles par un pipeline RAG, de fuite de secrets et d’exécution de code non autorisé liée à des configurations de dépôts malveillantes.
Ces problèmes ne se règlent pas tous par un meilleur tableau de bord : certains demandent des tests, d’autres une limitation des accès et une décision explicite sur le périmètre autorisé.
Comparer le défaut observé au contrôle utile
Le tableau ci-dessous est une grille de décision construite à partir des cas rapportés. Il ne s’agit pas d’une garantie qu’un contrôle isolé détectera toutes les défaillances.
| Risque | Ce qui peut passer inaperçu | Contrôle à cadrer |
|---|---|---|
| Dérive sémantique | Une réponse techniquement exploitable, mais fondée sur une interprétation métier incorrecte. | Tester des exemples représentatifs du vocabulaire et des règles propres aux domaines concernés. |
| Dérive des embeddings | Un changement de seuil ou de distribution qui modifie les décisions sans panne d’infrastructure. | Suivre les résultats métier en production et réévaluer le comportement après les changements de modèle. |
| Code généré en volume | Des tests qui passent sans vérifier la logique attendue. | Automatiser les contrôles tactiques et vérifier que les tests détectent des mutations de code. |
| Agent trop autonome | Une action permise techniquement, mais trop risquée ou insuffisamment encadrée. | Attribuer une identité distincte, limiter les droits et isoler les secrets de l’environnement de l’agent. |
Pour la PME, l’arbitrage dépend du défaut à éviter. Ajouter des traces ne corrige pas une définition métier ambiguë. Renforcer la revue humaine de chaque ligne ne passe pas forcément à l’échelle si le volume de code augmente. Et un contrôle de qualité du modèle ne remplace pas une règle d’accès qui empêche un agent de lire ou modifier des ressources hors de son périmètre.
Construire des évaluations qui vivent avec le service
Une liste de tests exécutée une seule fois avant le lancement ne couvre pas les cas rencontrés ensuite.
Le compte rendu rapporte la recommandation de traiter les évaluations comme une infrastructure permanente : suivre les interactions au niveau des étapes d’exécution, filtrer les journaux, catégoriser les motifs d’échec et réinjecter des cas limites observés en production dans les jeux d’évaluation hors ligne.
Une évaluation hors ligne est une vérification menée sur des exemples préparés, plutôt qu’au fil des interactions réelles.
Cette boucle suppose de définir ce qui constitue une réponse acceptable avant de regarder les résultats.
Pour une requête métier, cela signifie rendre explicites les termes ambigus et les règles attendues ; pour une décision fondée sur des embeddings, vérifier le comportement associé aux changements du modèle ; pour du code généré, déterminer les propriétés que les tests doivent réellement détecter.
Les exemples et seuils doivent correspondre au cas d’usage de l’entreprise : un indicateur de couverture seul ne prouve pas qu’un test met à l’épreuve la logique attendue.
Le compte rendu mentionne aussi les tests par mutation : modifier volontairement du code pour vérifier si la suite de tests détecte l’altération. Pour une entreprise, c’est une façon de poser une question vérifiable : les tests réagissent-ils à une logique incorrecte, ou valident-ils surtout que le code a été exécuté ?
L’automatisation peut prendre en charge les contrôles tactiques de style et de syntaxe dans la chaîne CI/CD ; l’examen humain reste à concentrer sur l’architecture, l’intention métier et les exigences non fonctionnelles.
Pour structurer cette partie de la chaîne, une grille de contrôles pour un pipeline CI/CD sécurisé peut compléter l’analyse, sans se substituer aux évaluations spécifiques de l’agent.
Limiter l’impact avant d’élargir l’autonomie
Les évaluations aident à repérer certains défauts ; les règles d’accès limitent ce qu’un agent peut faire lorsqu’un défaut survient.
Le compte rendu recommande des identités non humaines distinctes, des contrôles d’accès par niveau séparant notamment la lecture des écritures réversibles, le versionnement des dépendances MCP et l’isolation des secrets API hors de l’environnement d’exécution de l’agent.
Il rapporte aussi la nécessité de définir un périmètre fonctionnel strict, de mener des exercices de red team et de ne pas compter sur le seul prompt pour défendre le système.
Avant une mise en production, le dossier de décision peut donc distinguer les opérations de lecture, les écritures réversibles et les actions qui exigent un accord humain. Il doit préciser l’identité utilisée, les ressources accessibles, la manière de traiter les secrets, les changements de dépendances et les preuves d’évaluation attendues. Ce cadrage ne supprime pas le risque : il rend plus explicites les conséquences possibles d’une erreur et les personnes qui autorisent l’élargissement du périmètre.
Les coûts à estimer suivent ces contrôles : automatisation dans la chaîne de livraison, collecte et filtrage des traces, préparation des exemples métier, suivi des dépendances et gestion des accès. Le périmètre et les outils retenus déterminent l’effort ; aucun montant universel ne peut être déduit des cas rapportés.
Le responsable métier doit aussi préciser les conséquences d’un faux positif ou d’un faux négatif, car les priorités de test ne sont pas identiques pour une erreur gênante et pour une décision qui bloque un processus sensible.
Enfin, la validation des garde-fous et l’autorisation de déployer ne sont pas la même décision. Le compte rendu attribue aux équipes d’ingénierie, de sécurité et de confidentialité la validation des protections, tout en présentant l’approbation du déploiement comme un arbitrage stratégique de l’entreprise.
Une supervision utile relie ainsi un signal technique à une conséquence métier, à une action possible et à un responsable habilité à décider. Des repères complémentaires sur la supervision et le tri des alertes informatiques peuvent aider à cadrer cette dernière étape.
Pour comparer une solution ou une prestation, demandez des exemples de cas d’évaluation, les critères associés, les traces disponibles et la description des droits effectifs de l’agent. Le choix ne porte pas seulement sur la capacité à détecter une panne : il porte sur la capacité à repérer un résultat métier devenu incohérent, à comprendre ce que l’agent a pu faire et à décider, preuves à l’appui, si son périmètre peut être élargi.
Discussion
Vos retours sur cet article
Partagez une expérience ou posez une question utile aux autres lecteurs. Chaque message est relu avant publication.
Ajouter un commentaire
Votre adresse e-mail reste privée.