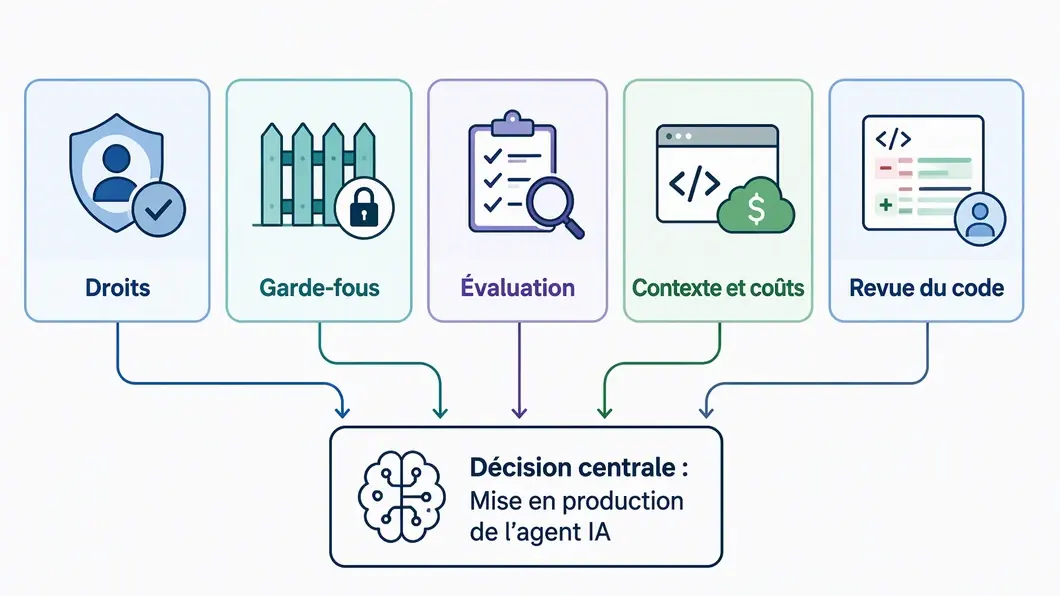
Un agent qui fonctionne en démonstration n’est pas encore prêt pour la production. Il faut décider ce qu’il peut faire, comment vérifier ses résultats et comment suivre les coûts quand les usages réels s’installent. Les sessions annoncées pour QCon AI New York 2026 abordent ces problèmes sous des angles distincts : autorisation des agents, garde-fous côté serveur, évaluation, gestion du contexte LLM et revue du code généré.
InfoQ rapporte que la conférence se tiendra les 15 et 16 décembre au Westin Jersey City Newport, à environ cinq minutes du World Trade Center par le PATH.
Son article sur les sessions annoncées décrit des retours d’expérience de production, pas une méthode universelle à appliquer telle quelle.
Pour une PME, leur intérêt est d’aider à formuler les décisions et les preuves à demander avant d’élargir un usage.
La grille ci-dessous ne remplace pas une analyse du système concerné. Elle aide à relier chaque risque à une décision vérifiable : une règle d’accès, un seuil d’évaluation, une mesure de consommation ou un contrôle humain explicite.
1. Définir les droits de l’agent avant de lui confier une tâche
La keynote de Nancy Wang traite de l’identité et de l’autorisation des agents en production, entre compte de service durable trop permissif et accès si étroit que l’agent ne peut achever sa tâche. Ce dilemme est un bon point de départ pour le cadrage : l’agent doit-il seulement consulter, préparer une action ou pouvoir la déclencher ?
Une PME peut traduire cette question en une matrice simple, avant même de choisir une solution technique. Pour chaque tâche, elle précise les données accessibles, les outils appelables, les actions permises et les cas où une personne doit approuver. Il faut aussi nommer le responsable qui peut modifier ou retirer ces droits. « L’agent a accès au CRM » ne suffit pas : la portée de l’accès et les opérations permises doivent être compréhensibles par l’équipe métier comme par l’équipe informatique.
La session de Ronak Nathani doit présenter des garde-fous installés côté serveur, notamment des limites de débit et une approbation par les pairs pour les changements en production, autour d’un agent d’exploitation Kubernetes. Pour un projet de PME, l’enseignement à retenir n’est pas de reproduire une architecture de grande plateforme, mais de demander où se trouvent les contrôles et s’ils restent appliqués lorsque l’agent ou son interface évolue.
Si le besoin peut être couvert par des règles déterministes ou un workflow classique, comparer ces options avant de retenir un agent reste pertinent : choisir entre un agent IA et une automatisation classique.
2. Vérifier que l’évaluation aide vraiment à décider
Une note de test n’est utile que si l’équipe sait ce qu’elle autorise à faire. La session annoncée par DoorDash porte sur l’usage d’un même évaluateur pour les sessions simulées et celles de production, afin que les améliorations mesurées avant lancement restent pertinentes une fois le système en service. C’est une proposition rapportée par InfoQ, pas la preuve qu’un évaluateur unique convient à tous les cas.
Pour cadrer un pilote, commencez par définir les erreurs qui changeraient la décision : réponse incorrecte, action non autorisée, tâche laissée inachevée ou intervention humaine nécessaire. Décrivez ensuite les exemples utilisés pour tester ces cas et la règle qui déclenche une mise en attente ou un arrêt. Une moyenne seule peut masquer un échec rare mais important ; les résultats doivent donc rester lisibles par type de tâche et par conséquence métier.
Avant le lancement, faites préciser comment les cas simulés correspondent aux demandes réelles et comment les désaccords entre évaluateur et relecteur humain seront traités. En production, une variation des demandes peut rendre un test antérieur moins représentatif. Le livrable attendu n’est pas seulement un score : c’est aussi la définition de la mesure, les cas couverts, les limites connues et la personne qui tranche lorsque le signal est ambigu.
3. Relier le coût du contexte à l’usage réel
La session de Tejas Chopra doit aborder compression et ordonnancement des prompts pour augmenter les cache hits fournisseur, le stockage hiérarchisé de l’historique et les modes de défaillance rencontrés par son équipe. Le point de décision pour une PME est plus large que le prix d’un appel : quelles informations doivent être transmises à chaque étape, et quelle valeur métier justifie cette consommation ?
Avant d’optimiser, identifiez les tâches qui répètent de longs historiques ou réutilisent des instructions. Séparez le volume de demandes, la taille du contexte et le coût associé quand ces données sont disponibles dans les outils utilisés. Puis vérifiez qu’une réduction ou une réorganisation du contexte ne retire pas une information nécessaire à la tâche.
L’article d’InfoQ ne fournit pas de chiffres de coûts à transposer : un budget doit être estimé avec les tarifs, le modèle, les volumes et le périmètre propres au projet.
Le livrable utile est un relevé exploitable, associé aux cas d’usage : consommation observée, limites de mesure, hypothèses de volume et comportement prévu lorsque le budget ou une limite technique est atteint. Sans ce lien, une optimisation peut réduire une ligne de dépense sans montrer si le service continue à répondre au besoin.
4. Éviter que la production de code dépasse la capacité de revue
InfoQ décrit la revue humaine comme un goulot d’étranglement lorsque les outils d’IA produisent davantage de code ; Min Chen propose de filtrer les résultats de faible confiance avant de les montrer aux développeurs. L’article indique que le système présenté traite des dizaines de milliers de pull requests par semaine sur environ 10 000 dépôts, et que la session abordera la mesure des suggestions intégrées au code fusionné. Ces volumes décrivent le cas rapporté, pas une référence de capacité pour une PME.
À l’échelle d’une équipe plus petite, le cadrage peut porter sur la responsabilité de la validation : quelles modifications peuvent être proposées, quels tests sont obligatoires, quels changements exigent une revue humaine et comment repérer les suggestions incorrectes ? Une mesure d’adoption ne répond pas à ces questions. Il faut distinguer le code produit du code accepté, puis examiner les corrections et le temps de revue sans supposer que toute suggestion générée apporte un gain.
Une chronologie de décision, du pilote à l’exploitation
Cette chronologie est une méthode de cadrage proposée, pas le programme de la conférence. Elle évite de traiter les permissions, la qualité et les coûts comme des vérifications séparées à la toute fin.
| Étape | Décision à prendre | Élément à conserver |
|---|---|---|
| Avant le pilote | Définir la tâche, les droits et les erreurs qui bloquent l’usage. | Matrice d’accès et cas de test. |
| Pendant le pilote | Comparer les résultats évalués aux contrôles humains et aux demandes observées. | Mesures documentées et limites du test. |
| Avant la production | Fixer les seuils d’approbation, le suivi de consommation et les conditions d’arrêt. | Règles d’exploitation et responsabilités nommées. |
| Après le lancement | Réexaminer les cas d’échec, les coûts et les changements de comportement. | Journal des décisions et critères de révision. |
Les livrables à demander avant d’élargir l’usage
Avant d’autoriser un déploiement plus large, un décideur peut demander des réponses écrites à quelques questions précises :
- Quelles actions et données l’agent peut-il utiliser, et qui valide une modification de ses droits ?
- Quels cas d’évaluation bloquent le lancement, et comment les résultats sont-ils rapprochés des contrôles humains ?
- Comment sont estimés et suivis les coûts, avec quelles hypothèses de volume et quelles limites de mesure ?
- Quelles modifications de code restent soumises à une revue humaine, et quelles preuves de validation sont conservées ?
- Qui peut suspendre l’usage, et sur quels signaux documentés ?
Les sessions annoncées pour QCon AI New York 2026 couvrent des problèmes différents, mais elles convergent vers une exigence de pilotage : relier autonomie, vérification et coût à des décisions attribuées. Pour une PME, un pilote devient plus défendable lorsque les droits, les critères de qualité, les hypothèses de coût et les conditions d’arrêt sont écrits avant que l’usage ne s’étende.
Discussion
Vos retours sur cet article
Partagez une expérience ou posez une question utile aux autres lecteurs. Chaque message est relu avant publication.
Ajouter un commentaire
Votre adresse e-mail reste privée.