Un workflow logiciel n’est pas optimisé parce qu’une tâche finit plus vite ou qu’une facture cloud baisse. Pour une PME, la décision utile est de savoir si une pratique — tests, outil de navigation du code ou assistance par IA — améliore le résultat livré sans déplacer le coût vers les corrections, l’exploitation ou le temps de l’équipe.
Dans un compte rendu publié le 15 octobre 2026, InfoQ rapporte les propos de Titus Winters lors d’une conférence et l’entretien qui a suivi. Il distingue le développement, processus créatif, le déploiement, davantage comparable à une activité de production, et l’exploitation, où l’automatisation joue un rôle important.
Ces étapes réclament des modes de pensée, des mesures et des investissements différents.
Le compte rendu et l’entretien publiés par InfoQ exposent aussi un point de vigilance : suivre les dépenses de calcul est plus simple que comprendre où passe le temps d’ingénierie.
Un démonstrateur fictif plutôt qu’une promesse de gain
Imaginons une PME qui hésite à imposer davantage de tests automatisés ou à fournir un index sémantique du code à ses développeurs. Cette situation est un scénario fictif, pas un retour d’expérience. Les deux options peuvent consommer davantage de ressources au départ ; l’enjeu est de vérifier si elles rendent certaines tâches plus fiables ou moins coûteuses au total.
Le piège serait de déclarer l’index gagnant parce qu’un agent produit plus vite une modification, ou les tests perdants parce qu’ils demandent du temps de calcul. Une modification qui échoue à un critère fonctionnel, entraîne une reprise ou fragilise le produit n’a pas la même valeur qu’une modification acceptée du premier coup. Le résultat doit donc être jugé sur plusieurs dimensions, et pas sur un indicateur isolé.
Quatre effets à garder dans le même arbitrage
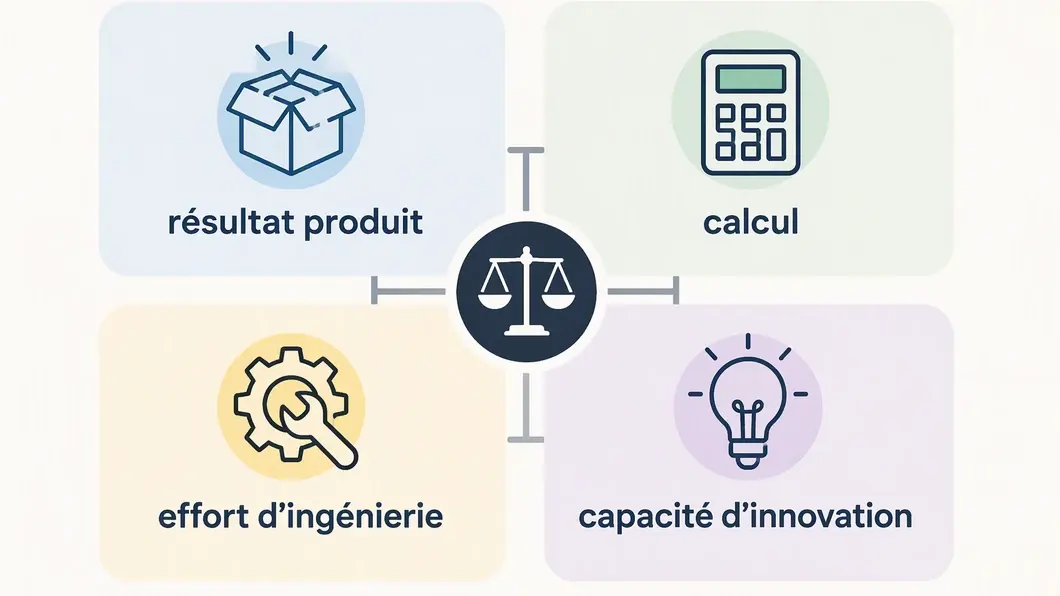
Winters propose de considérer ensemble la réussite du produit, la capacité de calcul, la capacité d’ingénierie et l’innovation stratégique. Pour un décideur, ces catégories évitent de confondre coûts visibles et coûts utiles :
- Résultat produit : adoption, satisfaction ou contribution au revenu, si l’entreprise dispose d’une manière pertinente de les observer.
- Calcul : dépenses de cloud, de stockage ou de réseau associées au processus évalué.
- Effort d’ingénierie : temps consacré à comprendre, produire, vérifier et corriger le changement. Il est plus difficile à suivre qu’une dépense de calcul et ne se résume pas mécaniquement à un compteur.
- Capacité d’innovation : possibilités nouvelles rendues abordables, ou problèmes récurrents devenus plus rares.
Le compromis entre ces effets compte davantage qu’une baisse locale. Le compte rendu rapporte, par exemple, l’avertissement de Winters selon lequel réduire le nombre de tests peut économiser du calcul, mais aussi créer des problèmes de qualité ou de l’épuisement lorsque l’équipe cherche ensuite à stabiliser le produit. Il ne s’agit pas d’un résultat chiffré ni d’une preuve que toute réduction de tests produit ces effets : c’est un risque à intégrer au protocole.
Comparer une pratique sans inventer de mesure
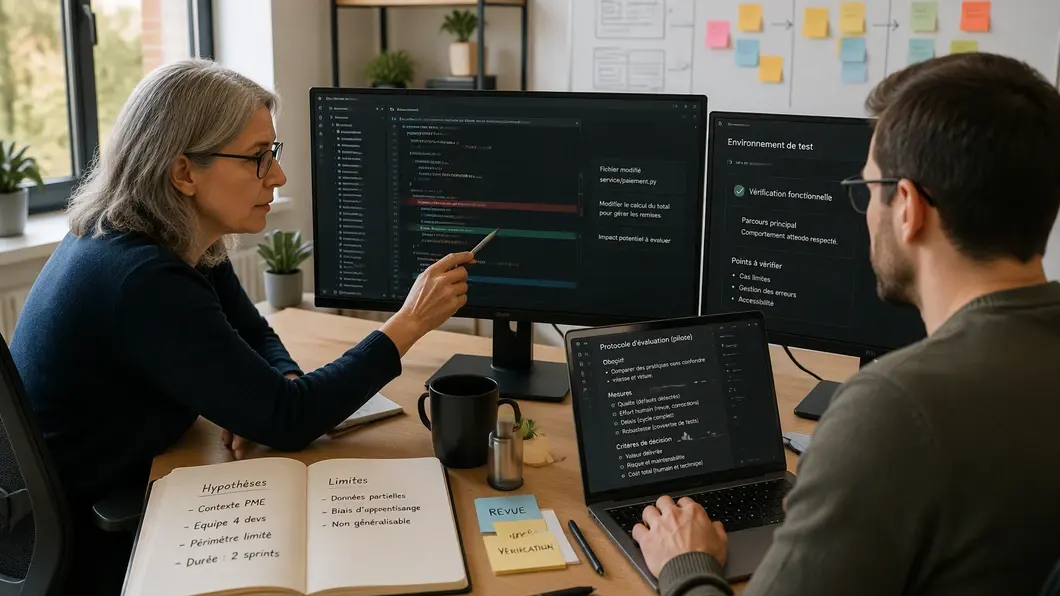
Pour le démonstrateur fictif, l’équipe peut définir un petit protocole avant de choisir un outil ou de généraliser une pratique. L’approche suivante reprend les pistes d’expérimentation attribuées à Winters par InfoQ ; elle ne constitue pas un test déjà réalisé.
- Choisir des tâches représentatives. Séparer, par exemple, ajout de fonctionnalité, correction de bug et refactorisation si ces travaux existent dans le périmètre. Noter les différences de difficulté et de plateforme plutôt que de tout mélanger.
- Écrire les critères d’acceptation. Définir à l’avance ce qui rend une tâche fonctionnellement correcte et suffisamment qualitative. Dans la proposition rapportée, ces critères sont cachés à l’agent évalué afin qu’il ne puisse pas simplement optimiser sa réponse en les connaissant.
- Comparer une seule variable. Pour étudier une pratique de tests, opposer deux consignes distinctes ; pour étudier un index, comparer son accès avec une approche standard. Garder autant que possible les autres conditions constantes.
- Répéter les essais et consigner les consommations. Winters propose de mesurer les tokens consommés pour chaque exécution et de répéter les essais. Le nombre de tokens est ici un indicateur expérimental proposé, pas une mesure directe et universelle du coût humain ou de la valeur métier.
- Examiner aussi les échecs et les reprises. Une exécution peu coûteuse qui ne passe pas les critères ne doit pas être assimilée à une économie. Consigner les corrections nécessaires et les limites du périmètre avant toute décision.
Une grille de tâches, de critères, de conditions comparées et de résultats rend le pilote vérifiable. Pour formaliser les besoins et les critères d’acceptation avant de lancer ce travail, l’entreprise peut aussi s’appuyer sur son cadrage de cahier des charges informatique.
Ce que l’essai permet — et ne permet pas — de conclure
Une série d’essais circonscrite peut aider à choisir une pratique pour les tâches et les conditions testées. Elle ne démontre pas automatiquement qu’elle fonctionnera de la même manière sur d’autres langages, applications, équipes ou niveaux de difficulté. Le compte rendu d’InfoQ rapporte justement la nécessité de couvrir plusieurs types de tâches, plateformes, langages et difficultés dans une suite d’évaluation robuste. La variété n’est pas un détail : elle conditionne la portée de la conclusion.
Le suivi des tokens reste une approximation expérimentale dans la proposition rapportée, non un substitut établi à la mesure du temps humain. L’entretien souligne que déterminer si une tâche est réellement du gaspillage demande une compréhension fine du processus d’ingénierie.
Une PME doit donc expliciter ses hypothèses : quelles activités sont comptées, quelles reprises sont observées, et quel résultat du produit importe réellement ?
Pour examiner plus spécifiquement les coûts après génération de code par IA, une lecture complémentaire porte sur le coût de maintenance du code généré par IA.
Le livrable utile à la décision
Le pilote devrait se terminer par un dossier court : tâches retenues, critères d’acceptation, conditions comparées, résultats observés, consommations mesurées, reprises nécessaires et limites. Il peut conclure à un essai plus large, à une adoption restreinte ou à l’abandon de l’option. Sans données suffisantes, la conclusion honnête est de ne pas généraliser, plutôt que de transformer une hypothèse en gain annoncé.
Cette discipline aide aussi à ne pas réduire le rôle des développeurs à la production de code. Dans l’entretien rapporté par InfoQ, Winters décrit plutôt un déplacement vers la compréhension du problème, avec des garde-fous et des connaissances organisationnelles encodés dans le système. Pour le décideur, l’arbitrage porte donc autant sur la capacité de l’équipe à résoudre les bons problèmes que sur la vitesse d’exécution d’une tâche.
Discussion
Vos retours sur cet article
Partagez une expérience ou posez une question utile aux autres lecteurs. Chaque message est relu avant publication.
Ajouter un commentaire
Votre adresse e-mail reste privée.