Un traitement asynchrone déplace une action hors de la requête qui l’a déclenchée. L’application reçoit un événement, le place dans une file ou un broker, puis un worker le consomme plus tard. Ce découpage améliore la capacité à absorber des pics, mais il crée aussi de nouveaux points de contrôle : qui peut publier, qui peut consommer, combien de fois un message peut être traité, que devient une erreur et qui surveille les files secondaires.
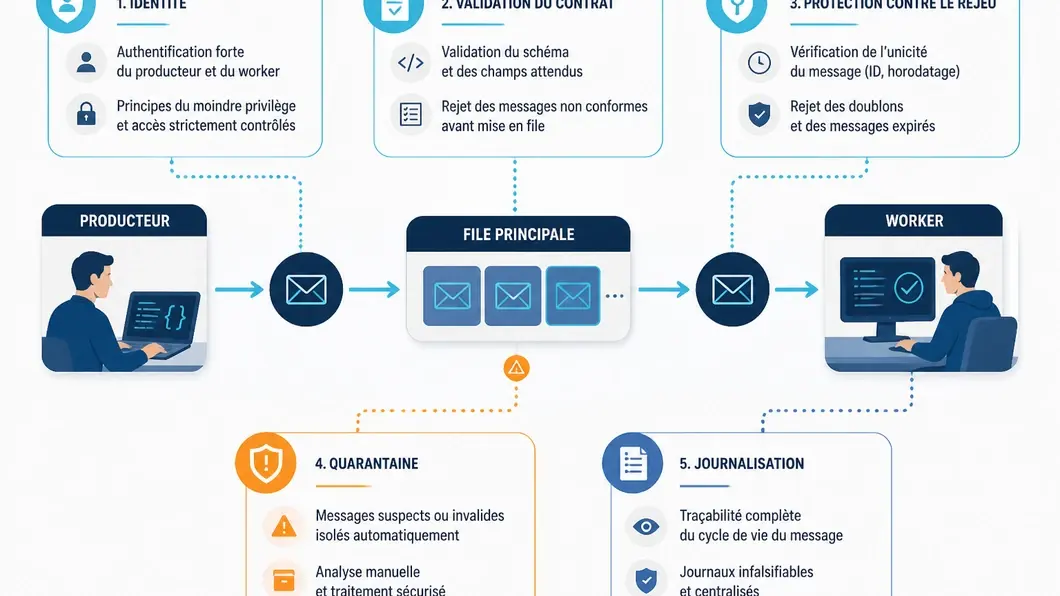
Pour un décideur de PME, le sujet n’est donc pas de choisir un outil de messagerie en premier. Il faut comparer les protections nécessaires selon le risque métier, les données transportées et les conséquences d’un message falsifié, rejoué ou bloqué. L’objectif est d’obtenir une architecture exploitable, avec des preuves vérifiables avant la mise en production.
Trois architectures, trois surfaces de risque
Les traitements asynchrones prennent des formes différentes. Une file interne entre une application et un worker ne présente pas les mêmes responsabilités qu’un échange d’événements entre plusieurs services ou qu’un traitement déclenché par un fournisseur externe. Dans les trois cas, le message devient une frontière de confiance à protéger.
| Architecture | Risque dominant | Contrôle à cadrer en priorité | Preuve attendue |
|---|---|---|---|
| File interne application-worker | Un worker consomme trop de droits ou traite un message forgé | Identité technique dédiée et validation du contrat de message | Matrice producteurs-consommateurs et tests de refus |
| Événements entre services | Rejeu, duplication ou propagation d’une décision erronée | Identifiant unique, contrôle d’idempotence et journal de décision | Scénarios de doublon, rejeu et message hors séquence |
| Webhook ou fournisseur externe | Événement usurpé, secret exposé ou dépendance indisponible | Authentification de l’émetteur, limitation du périmètre et procédure de coupure | Configuration documentée, rotation testée et runbook d’incident |
Cette grille évite de traiter la sécurité comme une couche uniforme. Un flux interne peut surtout exiger une séparation stricte des comptes et des permissions. Un événement reçu d’un tiers doit en plus prouver son origine et pouvoir être neutralisé rapidement.
Option 1 : sécuriser le canal et les identités
La première approche consiste à contrôler l’accès à la file ou au broker. Chaque producteur publie avec une identité technique distincte, chaque consommateur ne lit que les files nécessaires et les droits d’administration sont séparés des droits d’exécution. Cette option est lisible et constitue souvent le socle minimal d’un projet.
Elle ne suffit toutefois pas à établir qu’un message est légitime. Un compte autorisé peut publier une donnée incohérente, trop ancienne ou prévue pour un autre contexte. Le contrôle d’accès doit donc être complété par une validation applicative : type d’événement, version du contrat, identifiant de corrélation, date de création, périmètre métier et état attendu.
- Un compte de publication par service ou par domaine fonctionnel.
- Un compte de consommation limité aux files utiles.
- Une séparation explicite entre lecture, écriture, administration et purge.
- Une révocation testée, sans dépendre d’une intervention improvisée.
Option 2 : protéger la décision transportée
Dans un traitement asynchrone, le message peut déclencher une action sensible alors que l’utilisateur n’est plus présent. Le service qui consomme l’événement doit donc vérifier ce qu’il reçoit avant d’agir. Une signature ou un chiffrement peut protéger le transport, mais ne remplace pas le contrôle du contenu et du contexte.
Pour une commande, une mise à jour de droits ou un export, il faut notamment distinguer l’intention initiale de l’autorisation encore valable au moment de l’exécution. Un utilisateur pouvait être habilité lors de la demande et ne plus l’être lorsque le worker traite l’événement. La règle d’autorisation à appliquer doit être décidée dans le cadrage, puis testée sur des cas de changement d’accès.
Un message ne devrait pas embarquer plus de données que nécessaire. Réduire le contenu limite l’exposition dans les files, les journaux et les mécanismes de reprise. Lorsque le worker doit retrouver des informations complémentaires, le contrat doit préciser quelle source fait foi et comment un échec de lecture est traité.
Option 3 : traiter le rejeu comme un scénario de cybersécurité
Le rejeu est souvent présenté comme un problème de fiabilité. Il devient aussi un problème de sécurité lorsqu’un même événement peut déclencher plusieurs fois une action sensible : création d’un compte, paiement, changement de coordonnées, ouverture d’un accès ou envoi d’un document.
Une protection proportionnée combine généralement un identifiant d’événement unique, une durée de validité, un état de traitement conservé et une règle claire en cas de doublon. L’idempotence, c’est-à-dire la capacité à rejouer une même demande sans produire plusieurs effets indésirables, doit être vérifiée sur les actions réellement critiques et pas seulement déclarée dans la documentation.
Le choix dépend du métier :
- Refuser silencieusement un doublon peut convenir à une notification déjà envoyée.
- Reprendre après contrôle peut convenir à une synchronisation dont la source reste disponible.
- Déclencher une compensation peut être nécessaire lorsqu’une action partielle a déjà produit un effet.
- Mettre en quarantaine doit rester possible lorsqu’un message est suspect ou hors contrat.
Les files d’erreur ne doivent pas devenir un angle mort
Une dead-letter queue, ou file de quarantaine, reçoit les messages qui ne peuvent pas être traités normalement. Elle aide à isoler les erreurs, mais elle contient potentiellement des données métier et des demandes qui peuvent être rejouées. Ses accès, sa durée de conservation, sa purge et son mode d’analyse doivent donc relever du même cadrage de sécurité que la file principale.
Un prestataire doit rendre visibles les réponses à quatre questions : qui peut consulter la quarantaine, qui peut relancer un message, comment une relance est autorisée et quelle trace est conservée après la décision. Une simple alerte sur la longueur de la file ne permet pas de distinguer une panne, une attaque par saturation, un contrat incompatible ou une série de messages mal formés.
Quelle combinaison choisir pour une PME ?
Le bon niveau de contrôle dépend de l’effet produit par le traitement, et non du nombre de composants techniques. Une PME peut commencer par un flux critique et exiger une preuve complète avant d’étendre le modèle à d’autres événements.
| Situation | Socle recommandé | Contrôle supplémentaire | Décision à demander |
|---|---|---|---|
| Traitement interne à faible impact | Identités séparées, droits minimaux, validation de schéma | Journalisation des refus et des reprises | Qui peut arrêter ou relancer le worker ? |
| Donnée sensible ou action métier irréversible | Chiffrement adapté, idempotence, conservation de l’identifiant d’événement | Double validation ou compensation documentée | Quel état bloque automatiquement l’exécution ? |
| Échange avec un tiers | Authentification de l’émetteur, limitation des secrets, contrat versionné | Quarantaine et procédure de coupure | Comment continuer ou arrêter si le fournisseur est indisponible ? |
| Multiples services producteurs | Catalogue des événements, propriétaires et permissions par flux | Corrélation des traces et détection d’anomalies | Qui arbitre une évolution incompatible ? |
Les livrables à exiger avant la recette
Le cadrage devient vérifiable lorsque le prestataire ne remet pas seulement un schéma d’architecture. Demandez des artefacts qui permettent de tester les hypothèses et de reprendre la main en cas d’incident.
- Un inventaire des producteurs, consommateurs, files et propriétaires.
- Une matrice des permissions par identité technique.
- Le contrat de message avec versions, champs obligatoires et règles de rejet.
- Des scénarios de rejeu, doublon, message falsifié, retard et indisponibilité.
- La configuration de la quarantaine, de la purge et des accès d’exploitation.
- Un tableau des traces conservées, de leur durée et de leur minimisation.
- Un runbook pour suspendre, isoler, analyser puis reprendre un flux.
Les traces métier doivent compléter les journaux techniques. Pour approfondir la conception des événements et des décisions observables, consultez les traces à prévoir pour un traitement différé. Si le flux traverse plusieurs applications, le registre des dépendances SI aide à rendre visibles les propriétaires et les conséquences d’un changement.
Une décision de sécurité, pas seulement un choix de middleware
Comparer une file, un broker ou un service managé ne suffit pas. La décision porte sur les identités, le contenu des messages, la possibilité de rejouer, la quarantaine et les responsabilités d’exploitation. Une architecture asynchrone est prête lorsque l’équipe peut expliquer ce qui se passe dans le parcours nominal, mais aussi lorsqu’un événement arrive trop tôt, deux fois, avec de mauvais droits ou depuis une source devenue indésirable.
Commencez par un seul flux qui a un effet métier identifiable. Faites valider son contrat, ses contrôles, ses scénarios d’erreur et ses livrables. Cette approche limite le périmètre initial tout en produisant un modèle réutilisable pour les autres traitements.
Question de la rédaction : quel traitement asynchrone de votre système d’information vous semble le plus difficile à sécuriser aujourd’hui, et pourquoi ?
Discussion
Vos retours sur cet article
Partagez une expérience ou posez une question utile aux autres lecteurs. Chaque message est relu avant publication.
Ajouter un commentaire
Votre adresse e-mail reste privée.