Un agent IA qui doit répondre à partir d’informations récentes a besoin d’un accès au Web ; cet accès doit aussi laisser une trace exploitable et respecter les règles applicables aux données. L’API Web Search de Cloudflare vise à réunir la recherche et une partie de son administration dans AI Gateway.
Pour une PME, la question n’est donc pas seulement de savoir si l’API fonctionne : il faut déterminer si cette couche simplifie réellement l’architecture sans rendre opaques la conservation des résultats, les coûts ou les responsabilités.
Dans un article publié le 29 octobre 2026, InfoQ rapporte le lancement en bêta de l’API Web Search via AI Gateway.
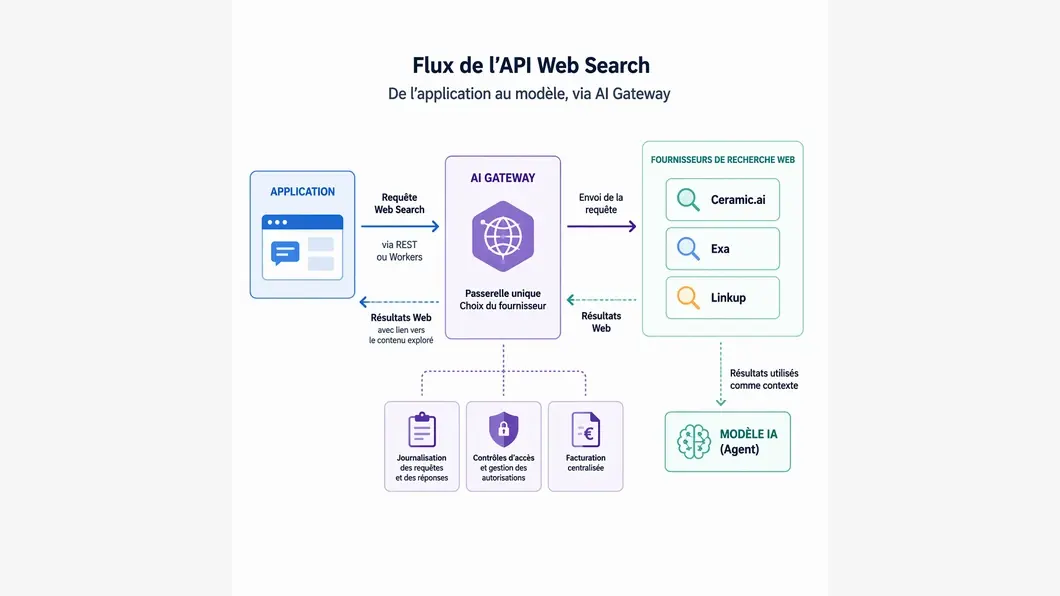
L’article décrit un accès par API REST et par Cloudflare Workers, avec des fournisseurs de recherche tels que Ceramic.ai, Exa et Linkup. Ces éléments décrivent la présentation rapportée à cette date ; ils ne constituent pas une vérification indépendante de la disponibilité actuelle de chaque fonction.
Le point de départ : où la recherche s’insère-t-elle dans le flux ?
Le besoin métier détermine l’endroit où cette API a de la valeur. Une réponse d’agent qui doit utiliser une documentation à jour n’a pas les mêmes contraintes qu’un assistant qui recherche des informations sans les conserver. Dans les deux cas, il faut distinguer au moins trois responsabilités : l’application décide quand lancer une recherche, le fournisseur renvoie des résultats, et le modèle exploite ces résultats pour produire une réponse.
Le problème décrit par les responsables de Cloudflare à InfoQ est concret : un agent peut tenter de deviner l’adresse d’une page, puis échouer lorsque l’URL est incorrecte. Une recherche web fournit une autre voie pour trouver du contenu en direct. Elle ne garantit cependant ni que les résultats répondent au besoin métier, ni que la réponse générée les interprète correctement. La recherche apporte du contexte ; elle ne remplace pas les contrôles de qualité de la réponse.
AI Gateway ajoute une couche commune d’accès. InfoQ indique qu’elle rassemble la journalisation des recherches et de l’inférence du modèle, des contrôles d’accès et la facturation. L’interface peut aussi accepter les clés de fournisseur apportées par le client. Cette centralisation peut faciliter le suivi d’un flux, mais elle ne suffit pas, à elle seule, à établir qui peut consulter les traces, combien de temps elles sont conservées ou quels droits s’appliquent aux résultats.
Arbre de décision : intégrer maintenant, ou garder une autre voie ?
Votre application doit-elle obtenir des contenus Web récents pendant l’exécution ? Si non, une API de recherche n’est peut-être pas la bonne réponse au besoin : commencez par préciser quelle source manque et pourquoi.
Si oui, voulez-vous utiliser une interface de recherche commune avec des fournisseurs nommés dans le compte rendu ? La bêta décrite par InfoQ donne accès à Ceramic.ai, Exa et Linkup. Vérifiez dans votre contexte les fournisseurs effectivement disponibles et les résultats nécessaires avant de retenir cette voie.
Le besoin principal est-il de centraliser le suivi et l’administration avec des appels de modèle ? Les fonctions rapportées d’AI Gateway peuvent alors être pertinentes. Si votre priorité est plutôt une règle particulière de conservation, de classement ou de stockage des résultats, faites-en un critère bloquant à vérifier dans les conditions du fournisseur et dans votre implémentation.
Le flux est-il accepté par vos équipes métier, IT et sécurité ? Si les rôles, les données envoyées ou le traitement des résultats ne sont pas définis, limitez-vous à un cadrage : ne laissez pas un agent utiliser la recherche en production avant d’avoir clarifié ces points.
Les résultats, les robots et les données : trois contrôles distincts
Cloudflare précise, selon les propos rapportés par InfoQ, que les fournisseurs doivent respecter ses exigences publiques concernant les « Verified bots » et que les réponses de recherche doivent comporter un lien vers le contenu exploré. Pour l’entreprise qui intègre l’API, la présence de ce lien aide à retrouver l’origine d’un résultat ; elle ne prouve pas que le contenu est exact, pertinent ou réutilisable sans restriction. La validation de la réponse reste donc une responsabilité applicative.
La conservation mérite une vérification séparée. InfoQ rapporte que Cloudflare prévoit d’identifier les fournisseurs prenant en charge Zero Data Retention, c’est-à-dire une option de non-conservation des données. Cette mention ne signifie pas que tous les fournisseurs ou tous les appels bénéficient de cette option.
Demandez quelles données sont concernées, quelles conditions s’appliquent au fournisseur choisi et si les résultats peuvent être stockés ou redistribués par votre application. L’article cite aussi une interrogation de la communauté sur le stockage et le partage des résultats : c’est un sujet contractuel à trancher, pas une fonction que l’on peut déduire de l’existence de l’API.
Coût et intégration : comparer le flux complet
Cloudflare indique que la recherche est facturée aux prix catalogue des fournisseurs, sans marge supplémentaire de sa part. Cela ne permet pas de calculer le coût total de votre usage : il dépendra notamment du fournisseur retenu, du volume réel de recherches et de la façon dont votre application appelle le service.
Avant un pilote, définissez une unité de suivi compréhensible par le métier, par exemple une tâche terminée, puis identifiez les coûts de recherche et ceux des appels au modèle dans le parcours correspondant.
Pour l’intégration, InfoQ indique qu’une application ou un service externe peut appeler un endpoint REST avec un jeton d’authentification AI Gateway et préciser le fournisseur dans la requête. Les équipes peuvent également s’appuyer sur Cloudflare Workers.
L’article présente les outils serveur natifs d’AI Gateway comme une évolution prévue ; jusqu’à cette évolution, Workers sont indiqués comme une voie d’intégration. Évitez donc de baser une décision sur une fonction annoncée comme future sans l’avoir vérifiée dans l’environnement concerné.
Le contrat d’API, la gestion des erreurs et l’observabilité restent à cadrer quel que soit le point d’entrée. Pour formaliser ces attentes, la lecture sur les contrats, le versionnement et l’observabilité d’une API complète utilement ce dossier.
Checklist avant un pilote
- Décrire le besoin métier qui justifie une recherche Web et les réponses attendues.
- Choisir un fournisseur à évaluer et vérifier les conditions d’accès, de conservation et de réutilisation des résultats.
- Préciser les données envoyées dans chaque requête, les droits associés au jeton et les personnes autorisées à consulter les journaux.
- Vérifier que les résultats incluent les liens vers les contenus explorés et définir comment l’application les présente ou les valide.
- Suivre séparément les appels de recherche et les appels au modèle, puis rapprocher ces dépenses d’une tâche métier mesurable.
- Prévoir un comportement explicite en cas d’échec de recherche : réponse différée, message d’indisponibilité ou traitement sans contenu récent.
- Fixer les critères de décision du pilote : utilité des résultats, qualité des réponses, traçabilité, conformité aux règles internes et coût observé.
Décision pratique
L’API Web Search de Cloudflare mérite un pilote si votre application a réellement besoin de résultats Web récents et si la centralisation de l’accès, des journaux et de la facturation répond à une difficulté existante. Elle ne règle pas automatiquement la qualité des réponses, les droits sur les contenus ou la politique de conservation.
Le livrable utile avant intégration est une courte description du flux — application, passerelle, fournisseur, modèle — accompagnée des règles de données, des critères de recette et des coûts à suivre. Si ces éléments restent flous, la prochaine étape est de les décider, pas d’accorder davantage d’autonomie à l’agent.
Discussion
Vos retours sur cet article
Partagez une expérience ou posez une question utile aux autres lecteurs. Chaque message est relu avant publication.
Ajouter un commentaire
Votre adresse e-mail reste privée.