Pour choisir entre Liquid Clustering, Z-Order et partitionnement sur Delta Lake, commencez par vos requêtes les plus fréquentes : leurs filtres sont-ils stables et toujours portés par les mêmes colonnes, ou changent-ils selon les usages ?
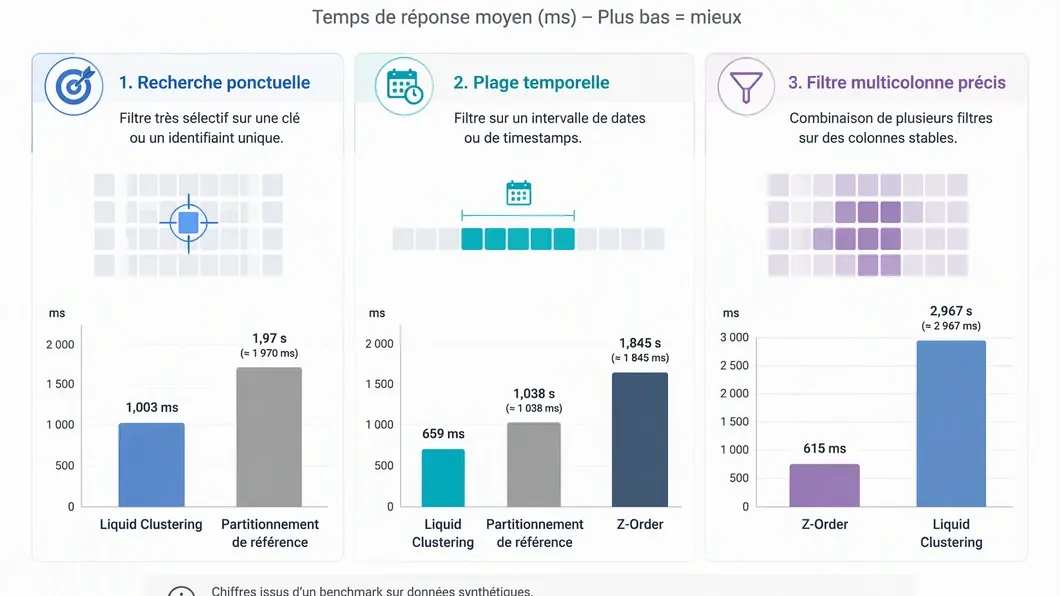
Dans un benchmark publié par InfoQ, un jeu synthétique de 50 millions d’enregistrements a servi à comparer ces trois organisations sur quatre familles de requêtes.
Les résultats ne désignent pas un vainqueur universel : ils illustrent surtout des arbitrages différents entre éliminer des fichiers et lire efficacement les données restantes.
Pour une équipe de PME, la conséquence pratique est simple : ne validez pas un choix de stockage à partir d’un seul indicateur, ni d’un scénario qui ne ressemble pas à l’activité réelle. La latence, les colonnes filtrées et la régularité des requêtes comptent ensemble.
Ce que le benchmark compare réellement
Les trois stratégies n’organisent pas les données de la même façon. Le partitionnement sépare les données selon une ou plusieurs valeurs, ici notamment une date. Z-Order ordonne les données pour favoriser l’élimination de fichiers correspondant aux filtres. Liquid Clustering vise plutôt une localité utile à plusieurs profils de requêtes : la localité désigne ici le regroupement de données liées dans les fichiers, afin de rendre leur lecture plus efficace.
Le benchmark oppose ainsi deux mécanismes qui peuvent produire des résultats différents. Le « pruning », ou élimination de fichiers, réduit la quantité de données à lire. La localité à l’intérieur des fichiers peut, elle, accélérer le parcours des données effectivement lues. La quantité d’octets scannés ne suffit donc pas à prédire la latence.
| Profil de requêtes | Option à examiner | Arbitrage observé dans le benchmark |
|---|---|---|
| Filtres divers ou susceptibles d’évoluer | Liquid Clustering | Meilleure latence rapportée pour les recherches ponctuelles, les plages temporelles et les agrégations larges. |
| Filtres multicolonnes stables, sélectifs et alignés sur les clés | Z-Order | Meilleur résultat sur ce workload précis, grâce à une élimination de fichiers plus ciblée. |
| Requêtes temporelles et date comme clé secondaire ou tertiaire de Z-Order | Comparer au partitionnement par date | Le benchmark rapporte une forte dégradation de Z-Order sur son scénario de plage temporelle. |
Ce tableau résume des observations issues d’un test déterminé ; il ne remplace pas une mesure sur les données et les requêtes de l’entreprise.
Quand la flexibilité de Liquid Clustering est utile
Sur les recherches ponctuelles, Liquid Clustering a obtenu une latence de 1,003 seconde, annoncée comme 49 % plus rapide que la référence partitionnée, tout en lisant davantage de données brutes que Z-Order. L’explication avancée dans l’article est que la localité au sein des fichiers peut accélérer leur lecture et compenser le volume supplémentaire parcouru.
Dans le workload de plage temporelle, Liquid Clustering a atteint 659 millisecondes. Le partitionnement a pris 1,038 seconde, tandis que Z-Order a pris 1,845 seconde, soit 78 % de plus que le partitionnement dans ce test. La clé Z-Order utilisée était (customer_id, region, txn_date) : la date étant en troisième position, les valeurs temporelles séquentielles se trouvaient dispersées entre les fichiers, selon l’analyse du benchmark.
Une troisième mesure, une agrégation large sans filtre, favorise également Liquid Clustering dans les résultats rapportés : l’article indique 659 millisecondes, contre 1,845 seconde pour Z-Order. Sans filtre sélectif, éliminer des fichiers apporte moins ; l’efficacité de lecture à l’intérieur des fichiers prend davantage d’importance.
Quand Z-Order peut rester le meilleur choix
Le cas inverse apparaît lorsque les requêtes utilisent toujours les mêmes filtres multicolonnes sélectifs et que ces colonnes correspondent précisément aux clés de clustering. Sur ce workload, Z-Order a pris 615 millisecondes et lu 59,03 Mo. Liquid Clustering a pris 2,967 secondes et lu 639,95 Mo : près de cinq fois plus longtemps et environ dix fois plus de données lues dans ce scénario.
Il ne faut pas transformer ce résultat en règle générale contre Liquid Clustering. Il indique plutôt que la flexibilité peut coûter cher lorsque les filtres sont étroits, prévisibles et parfaitement alignés sur une combinaison de clés connue. À l’inverse, l’auteur du benchmark recommande Liquid Clustering comme option par défaut pour des profils divers ou évolutifs, et Z-Order lorsque les filtres dominants restent stables et bien définis.
Une anecdote hypothétique pour tester le choix
Imaginez une PME qui analyse ses ventes : l’équipe finance filtre surtout par date, tandis que le service client cherche tantôt par région, tantôt par identifiant de client. Si ces usages changent au fil des rapports, une organisation adaptée à un seul couple de colonnes risque de moins bien servir les autres requêtes.
Si, au contraire, les tableaux de bord les plus utilisés filtrent durablement sur les mêmes colonnes, le scénario précis où Z-Order est performant mérite d’être mesuré. Ce cas est hypothétique ; il sert à formuler le test, pas à décrire une entreprise ou un résultat réel.
Mesurer avant de retenir une stratégie
Le benchmark utilise un jeu synthétique de 50 millions d’enregistrements, sur Delta Lake, avec des profils de requêtes Databricks. L’auteur précise que les données de production peuvent différer par leur schéma, la saisonnalité des accès et la distribution des valeurs. Les résultats sont donc une indication pour orienter un essai, pas une garantie de performance dans un autre environnement.
Avant de décider, sélectionnez vos trois principaux profils de requêtes et comparez les trois configurations sur un échantillon représentatif des données. Pour préparer cet échantillon sans exposer inutilement des données réelles, le comparatif des options de données de test peut aider à cadrer le choix.
- Reproduisez les filtres réellement utilisés, notamment les combinaisons de colonnes et les plages de dates.
- Mesurez la latence et les octets lus : un scan plus important ne signifie pas automatiquement une requête plus lente.
- Comparez les résultats workload par workload, plutôt que de retenir une moyenne qui masquerait un cas défavorable.
- Documentez les conditions de test et les limites de l’échantillon pour que la décision reste vérifiable.
Enfin, ne confondez pas performance de lecture et coût total. L’article indique que l’amplification des écritures et le calcul nécessaires au maintien de chaque organisation n’ont pas été mesurés. Le benchmark ne permet donc pas de conclure à un coût d’exploitation global inférieur pour l’une des stratégies. La décision doit associer le profil de lecture, les contraintes de maintenance et les résultats obtenus sur les propres données de l’entreprise.
Discussion
Vos retours sur cet article
Partagez une expérience ou posez une question utile aux autres lecteurs. Chaque message est relu avant publication.
Ajouter un commentaire
Votre adresse e-mail reste privée.