Une équipe numérique peut déjà utiliser un modèle de langage sans savoir si ses erreurs viennent du modèle, des informations qu’on lui fournit ou de la façon dont celles-ci sont organisées.
Les context language models (CLM) désignent une approche où le modèle peut gérer et modifier son propre contexte, au lieu de s’appuyer uniquement sur des mécanismes prédéfinis de résumé, de compression ou de recherche.
C’est la présentation qu’en donne l’article d’InfoQ consacré aux CLM. Elle ne suffit pas, à elle seule, à démontrer qu’un CLM convient à un service donné ni qu’il y réduira les coûts.
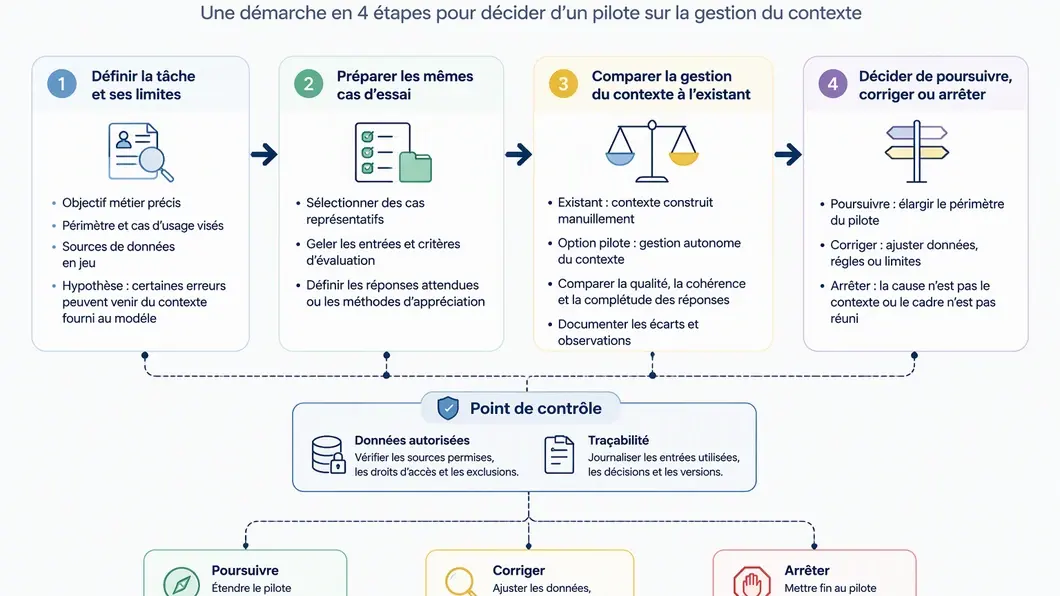
Pour une PME, la première décision n’est donc pas de choisir un modèle. Il faut déterminer si la gestion du contexte est réellement un irritant métier, puis établir ce qui permettrait de comparer cette approche à la solution actuelle. Le pilote doit produire des éléments vérifiables, pas une démonstration impressionnante.
Premier choix : le problème vient-il vraiment du contexte ?
Repérez une tâche précise où le système reçoit plusieurs informations et doit en retenir certaines pour répondre ou préparer une action. Une recherche dans des procédures, la préparation d’une synthèse technique ou le traitement d’une demande interne peuvent servir de cas à examiner. Ce sont des exemples de cadrage, pas des preuves qu’un CLM les améliore.
Avant tout essai, faites décrire par les personnes concernées ce qui échoue et à quel moment. Une réponse incorrecte peut venir d’une source obsolète, d’une règle ambiguë, d’une consigne mal formulée ou d’un contexte trop volumineux. Si l’équipe ne peut pas distinguer ces causes, elle ne pourra pas attribuer une éventuelle amélioration à la gestion du contexte.
- Si la tâche est stable et réglable par des règles simples, examinez d’abord une automatisation classique ou une amélioration du processus.
- Si la réponse dépend de documents identifiables, vérifiez d’abord la qualité des sources et la façon dont elles sont retrouvées.
- Si le système doit décider quelles informations conserver, modifier ou écarter, l’hypothèse d’une gestion du contexte plus autonome mérite d’être étudiée.
Pour poser ce diagnostic, partez du besoin métier avant de retenir une architecture, comme le recommande la démarche de cadrage d’un projet IA par le problème métier.
Deuxième choix : peut-on évaluer le résultat sans se fier à l’impression ?
Un essai est peu utile si l’équipe ne sait pas reconnaître une bonne réponse. Constituez un petit jeu de situations représentatives à partir de cas autorisés : une demande courante, une information manquante, deux consignes qui se contredisent ou une source qui ne devrait pas être utilisée. Pour chaque situation, notez le résultat attendu et les erreurs qui empêcheraient l’usage.
La comparaison doit conserver les mêmes entrées et le même objectif. Établissez d’abord une référence avec le mécanisme actuel, puis comparez-la à une option où le système gère davantage son contexte. Selon le problème observé, une troisième comparaison peut porter sur une recherche documentaire mieux réglée ou une sélection manuelle du contexte. Ne changez pas simultanément les données, les consignes et les critères : vous ne sauriez plus ce qui explique l’écart.
Les réponses ne sont pas le seul objet de contrôle. Consignez, dans la mesure nécessaire et autorisée, quelles informations ont été fournies, écartées ou modifiées, et à quelle version de la configuration correspond le résultat. Évitez de placer des données sensibles dans des journaux ou un jeu d’essai sans avoir défini les accès, la conservation et la procédure de suppression.
Troisième choix : un pilote est-il justifié ?
Un pilote devient défendable lorsque l’équipe a une tâche circonscrite, des situations de test, une référence de comparaison et une personne responsable de l’arbitrage. S’il manque l’un de ces éléments, le bon travail préalable peut être de clarifier les données ou les critères, plutôt que d’ajouter une nouvelle technologie.
La préparation des exemples doit aussi tenir compte de la provenance, de la représentativité et des précautions applicables aux données de test ; voir la comparaison des stratégies de données de test.
| Question de décision | À vérifier | Livrable utile |
|---|---|---|
| Le contexte est-il en cause ? | Identifier les erreurs liées à une information absente, inutile ou contradictoire. | Exemples de cas et causes supposées. |
| La comparaison est-elle équitable ? | Conserver les mêmes demandes, sources et critères entre les options. | Jeu d’essai versionné et résultats comparables. |
| Le comportement est-il maîtrisable ? | Vérifier ce qui peut être conservé ou modifié, et qui peut le contrôler. | Règles d’accès, de journalisation et de reprise. |
| Le coût complet est-il visible ? | Inclure l’intégration, l’évaluation, la supervision, les corrections et l’exploitation. | Hypothèses de coût et responsabilités attribuées. |
Le coût ne se résume pas au calcul effectué par le modèle. Estimez aussi le temps nécessaire pour préparer les exemples, examiner les réponses, maintenir les sources et intervenir en cas de comportement indésirable. Sans données recueillies dans votre propre périmètre, aucun gain ne peut être annoncé de façon crédible.
Une anecdote hypothétique : le résumé qui oublie la réserve
Imaginons une équipe qui prépare des réponses à des demandes de maintenance à partir d’anciens comptes rendus et de consignes récentes. Un résumé compact paraît pratique, mais omet parfois une réserve toujours applicable. L’équipe pourrait comparer ce résumé, une recherche documentaire classique et une gestion du contexte plus autonome sur les mêmes demandes.
Elle devrait aussi inclure un cas où la bonne réponse consiste à signaler une information absente plutôt qu’à compléter le dossier par supposition. Ce scénario est hypothétique : il ne rapporte ni test réalisé ni résultat mesuré.
Quatrième choix : poursuivre, corriger ou arrêter ?
Avant l’essai, écrivez les conditions qui feraient avancer le projet et celles qui imposeraient une pause. Une checklist courte évite de transformer une préférence pour la nouveauté en décision technique :
- le problème métier et le périmètre sont formulés sans ambiguïté ;
- les cas d’essai sont autorisés, documentés et suffisamment variés pour éprouver les erreurs attendues ;
- une comparaison avec l’existant est possible à critères constants ;
- les informations consultées ou modifiées restent contrôlables par l’équipe ;
- les coûts, les responsabilités d’exploitation et la conduite à tenir en cas d’échec sont explicités ;
- une personne désignée peut décider de poursuivre, de corriger le protocole ou d’arrêter.
Si les réponses sont favorables, poursuivez par un pilote limité dont les critères de qualité, de coût et de contrôle ont été consignés avant les essais. Si la qualité ne progresse pas selon ces critères, si la traçabilité est insuffisante ou si le coût complet reste indéterminé, suspendez l’extension et revenez à l’hypothèse de départ.
La présentation disponible des CLM décrit une approche de gestion du contexte, pas une garantie de performance pour votre application : la décision doit venir de vos propres évaluations, dans un cadre autorisé et maintenable.
Discussion
Vos retours sur cet article
Partagez une expérience ou posez une question utile aux autres lecteurs. Chaque message est relu avant publication.
Ajouter un commentaire
Votre adresse e-mail reste privée.