Un feature flag permet de modifier le comportement d’une application sans redéployer tout son code. Cette souplesse aide à ouvrir progressivement une fonction, à limiter son exposition ou à revenir rapidement à un comportement connu. Elle ne suffit toutefois pas à garantir la continuité : si le service qui fournit la décision devient indisponible, l’application doit encore savoir quoi faire.
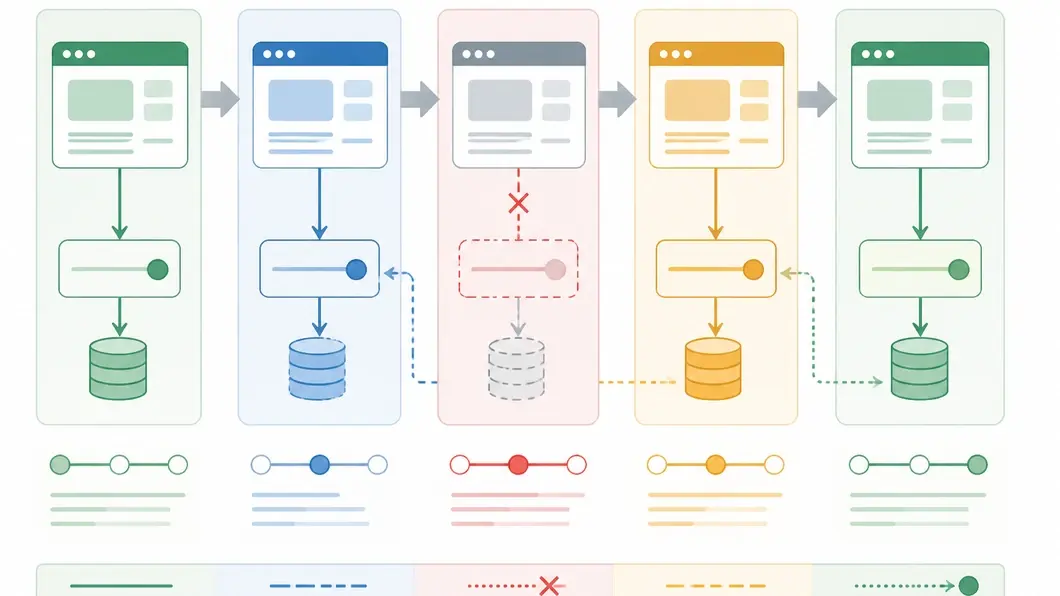
Le sujet n’est donc pas seulement l’activation du flag. Il faut cadrer le comportement de l’application lorsque la valeur est absente, ancienne, incohérente ou impossible à récupérer. Pour une PME, cette décision mérite d’être traitée comme un petit dispositif de continuité, avec un périmètre clair, un responsable et une preuve de test.
Étape 1 : partir de l’effet métier du flag
Commencez par décrire ce que la bascule change réellement. Un flag peut afficher un nouvel écran, modifier une règle de calcul, choisir un fournisseur, activer un traitement différé ou autoriser une action. Ces situations n’ont pas le même niveau de risque.
La première question est simple : que doit-il se passer si l’application ne peut pas obtenir la décision ? Pour une fonction de confort, conserver l’ancien comportement peut être acceptable. Pour une opération sensible, le choix peut être de bloquer l’action, de demander une validation humaine ou de limiter temporairement le périmètre.
- Décrire l’effet visible pour l’utilisateur et le métier.
- Identifier les données, flux ou droits concernés.
- Nommer le comportement attendu en cas d’absence de réponse.
- Préciser ce qui doit rester possible pendant l’incident.
Étape 2 : choisir une stratégie de repli explicite
Une stratégie de repli, ou fallback, est le comportement utilisé lorsque la décision du flag ne peut pas être obtenue normalement. Elle ne doit pas être laissée à une valeur par défaut cachée dans le code ou dans une bibliothèque.
Trois options reviennent souvent. Le repli vers l’ancien parcours préserve la continuité fonctionnelle, mais peut maintenir une ancienne dépendance. Le verrouillage préventif réduit le risque d’une action incorrecte, au prix d’une interruption partielle. Enfin, le mode limité permet de poursuivre uniquement les opérations dont les conséquences sont maîtrisées.
| Situation | Repli envisageable | Preuve attendue |
|---|---|---|
| Nouvel écran sans effet critique | Revenir à l’ancien parcours | Test d’affichage et vérification du parcours historique |
| Règle de calcul ou de tarification | Conserver la règle validée ou suspendre le calcul | Jeu de cas métier comparant les deux comportements |
| Action irréversible | Bloquer l’action et orienter vers une validation | Scénario d’erreur, trace de décision et procédure de reprise |
| Traitement dépendant d’un service externe | Mettre en attente sans créer de doublon | Test de reprise, d’idempotence et de surveillance |
Le choix doit être documenté par flag ou par famille de flags. Une règle générale appliquée partout peut sembler pratique, mais elle devient dangereuse lorsque les effets métier sont différents.
Étape 3 : séparer disponibilité du flag et autorisation
Un feature flag décide généralement quel comportement logiciel est exposé. Il ne doit pas devenir, à lui seul, un mécanisme d’autorisation. Un utilisateur peut être autorisé à voir une fonction sans que le flag soit activé, tandis qu’un flag actif ne doit pas donner un droit que le contrôle d’accès n’a pas accordé.
Cette séparation réduit le risque de transformer une panne du service de flags en ouverture involontaire. Le code doit vérifier les droits applicatifs selon les règles habituelles, puis appliquer la décision fonctionnelle. Pour approfondir ce point, voir aussi les décisions de cybersécurité à cadrer avant l’activation d’un feature flag.
Étape 4 : décider où conserver la dernière valeur connue
Une application peut parfois continuer à fonctionner avec une dernière décision valide mise en cache. Cette approche évite qu’une indisponibilité momentanée provoque immédiatement une interruption, mais elle pose une question : pendant combien de temps cette valeur reste-t-elle acceptable ?
Le délai doit dépendre de l’effet du flag. Une valeur conservée quelques minutes peut être acceptable pour un affichage. Elle peut être inadaptée à une règle de sécurité ou à une opération financière. Le cadrage doit donc préciser la durée de validité, le signal qui indique qu’une valeur est périmée et le comportement à adopter après expiration.
- Indiquer si la valeur peut être mise en cache.
- Définir une durée maximale de conservation.
- Afficher ou journaliser l’état périmé sans exposer de données inutiles.
- Prévoir une action lorsque la valeur ne peut plus être considérée comme fiable.
Étape 5 : tester les pannes qui comptent
Tester uniquement l’activation nominale ne permet pas de vérifier la continuité. Le scénario de recette doit provoquer les défauts plausibles : service de flags inaccessible, réponse trop lente, valeur mal formée, cache expiré, changement de périmètre ou retour à l’ancien comportement.
Un scénario hypothétique peut servir de base : une PME active progressivement un nouveau traitement de commandes. Le service de décision devient indisponible pendant la période d’activité. L’équipe vérifie que les commandes déjà engagées ne sont pas traitées deux fois, que les nouvelles demandes suivent le parcours prévu et que le support dispose d’un message compréhensible.
Les tests doivent être décidables. Pour chaque cas, indiquez l’état initial, l’action déclenchée, le résultat attendu, la trace produite et la personne qui valide. Les logs doivent permettre de distinguer une valeur active, une valeur en cache, une erreur de récupération et un repli automatique.
La journalisation ne doit toutefois pas recopier inutilement les données métier ; le cadrage des logs de données liés aux feature flags complète cette préparation.
Étape 6 : organiser la décision en exploitation
Un mode dégradé ne sert que si l’équipe sait le reconnaître et agir. Le tableau de bord doit signaler l’état du service de flags, l’âge de la dernière décision connue, les erreurs de récupération et les bascules de repli. Une alerte doit conduire à une action précise, pas seulement à une accumulation de notifications.
Le runbook associé doit répondre à quatre questions : comment confirmer le problème, quelle action est sûre, qui peut modifier ou désactiver le flag, et comment vérifier le retour à la normale. Si la modification nécessite une intervention manuelle, le contrôle d’accès et la traçabilité de cette intervention doivent être prévus avant la mise en production.
Les livrables à demander au prestataire
Une prestation de mise en place ou de sécurisation des feature flags doit produire davantage qu’une configuration fonctionnelle. Demandez des éléments directement vérifiables :
- une fiche par flag avec son objectif, son propriétaire, son périmètre et sa date de retrait prévue ;
- une matrice des comportements nominaux, dégradés et bloquants ;
- la description de la gestion du cache, de l’expiration et des erreurs de récupération ;
- les scénarios de recette exécutés avec leurs résultats ;
- un tableau des traces produites et des données volontairement exclues ;
- un runbook de bascule, de retour au comportement précédent et de reprise ;
- une liste des contrôles d’accès permettant de modifier le flag.
Checklist avant validation
- Le flag correspond-il à une décision métier identifiable ?
- Le comportement attendu est-il défini lorsque la décision est indisponible ?
- La valeur par défaut est-elle adaptée à l’effet produit ?
- La dernière valeur connue possède-t-elle une durée de validité ?
- Les droits applicatifs restent-ils séparés de la bascule fonctionnelle ?
- Les tests couvrent-ils l’indisponibilité, la lenteur et la reprise ?
- Les traces permettent-elles d’expliquer la décision sans exposer inutilement les données ?
- Un responsable peut-il modifier, surveiller et retirer le flag ?
Un feature flag apporte de la souplesse lorsqu’il est traité comme une décision temporaire. Pour la continuité, l’enjeu est plus précis : rendre explicite le comportement de l’application lorsque la bascule ne peut plus être évaluée. Cette préparation réduit les décisions improvisées et donne au prestataire un périmètre de travail contrôlable, avec des tests et des livrables que la PME peut réellement relire.
Discussion
Vos retours sur cet article
Partagez une expérience ou posez une question utile aux autres lecteurs. Chaque message est relu avant publication.
Ajouter un commentaire
Votre adresse e-mail reste privée.