Un agent de sécurité peut repérer une piste intéressante sans avoir démontré qu’elle est exploitable.
Selon l’article d’InfoQ sur PageBreak, qui rapporte un article scientifique publié par Google, PageBreak a découvert plus de 500 vulnérabilités XSS dans les applications web de Google depuis son passage en fonctionnement complet en janvier.
Ce chiffre est rapporté par Google : InfoQ précise qu’aucune validation indépendante de ces découvertes n’a été fournie.
Le point intéressant pour une PME n’est donc pas de reprendre ce résultat comme une promesse de performance. C’est de regarder où l’agent s’arrête et quelle preuve est exigée avant qu’une équipe reçoive un signalement. Une XSS, ou injection de script côté navigateur, n’est pas seulement une anomalie repérée dans du code : dans le fonctionnement décrit, la piste doit être reproduite sur une application en marche.
De l’hypothèse au constat : deux étapes qui ne se confondent pas
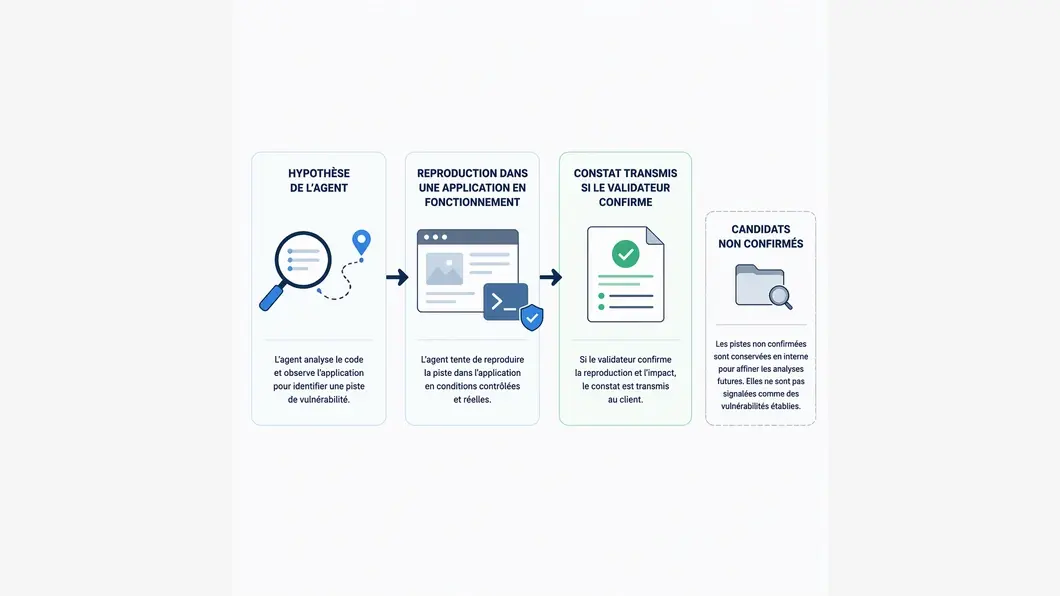
PageBreak utilise des modèles Gemini pour examiner de manière autonome des vulnérabilités potentielles, mais ne transmet un constat qu’après la reproduction de l’exploitation par des validateurs déterministes dans une application en fonctionnement. Autrement dit, le modèle peut suggérer une piste ; un mécanisme distinct doit ensuite établir qu’elle se concrétise dans l’environnement testé.
InfoQ décrit des validations adaptées au type de faille : pour une XSS, exécuter du JavaScript ; pour une traversée de chemin, écrire à un emplacement lisible publiquement ; pour une exécution de code à distance, déclencher une requête DNS sortante. Ces exemples montrent pourquoi une règle de validation doit être liée à un effet observable, plutôt qu’à une impression de plausibilité dans le code.
| Étape | Question à poser | Preuve attendue |
|---|---|---|
| Hypothèse de l’agent | Quelle faiblesse potentielle est signalée, et sur quelle cible ? | Une description exploitable par l’équipe, sans la traiter comme un défaut confirmé. |
| Validation | La piste peut-elle être reproduite dans une application en fonctionnement ? | Un résultat déterministe correspondant au type de vulnérabilité recherché. |
| Transmission | Le résultat a-t-il franchi le seuil défini pour alerter l’équipe produit ? | Un constat accompagné de sa preuve de reproduction et de son périmètre. |
Cette séparation déplace une partie du travail : au lieu de demander aux équipes produit de trier toutes les suggestions du modèle, le dispositif filtre les pistes avant leur transmission. Google rapporte que cette validation déterministe vise un taux de faux positifs proche de zéro. Il s’agit de la caractérisation donnée par Google, et non d’une mesure indépendante rapportée par InfoQ.
Un filtre plus strict réduit le bruit, mais ne garantit pas la couverture
Un seuil de confirmation exigeant a une contrepartie. Pour les hypothèses non confirmées, Google conserve les résultats en interne afin d’alimenter des scans ultérieurs, de repérer les limites des validateurs et d’orienter leur développement. Ces candidats ne sont pas présentés aux équipes produit comme des vulnérabilités établies.
InfoQ rapporte que les validateurs ne couvrent pas tous les types de vulnérabilités ni les scénarios complexes : cette limite laisse un risque de faux négatifs. Une faille réelle peut ainsi échapper au filtre si le validateur ne sait pas reproduire le scénario concerné. « Aucune alerte non confirmée » ne signifie donc pas « aucun risque ». Un dispositif qui optimise la fiabilité des signalements doit également rendre visible ce qu’il ne sait pas vérifier.
Pour choisir ou cadrer un outil, demandez donc deux résultats distincts : les constats reproductibles transmis aux équipes et la manière dont les hypothèses non confirmées sont conservées, examinées ou écartées. Les confondre rendrait difficile de savoir si un faible nombre d’alertes reflète une bonne précision ou une couverture étroite.
Ce qui rend le contexte de Google difficile à transposer
Les résultats rapportés reposent aussi sur un environnement technique particulier. PageBreak bénéficie d’un monorepo donnant une visibilité de bout en bout sur le code, de signaux reliant le trafic HTTP réel au code source et d’une infrastructure de scan disposant d’un accès authentifié aux applications web de Google. Ces éléments font partie du dispositif décrit ; ils ne prouvent pas qu’un outil similaire produirait les mêmes résultats dans un système d’information plus petit ou organisé autrement.
Avant un pilote, une PME a donc intérêt à préciser les applications incluses, les environnements accessibles, les droits utilisés et les signaux effectivement disponibles. Si les applications ne peuvent pas être testées en fonctionnement, ou si le trafic et le code ne peuvent pas être rapprochés, le périmètre de validation sera différent.
Le budget doit alors être estimé à partir du travail réellement nécessaire : préparation des environnements, création ou adaptation des validateurs, accès autorisés, traitement des résultats et maintenance des scénarios. La source ne fournit pas de coûts chiffrés permettant d’établir un montant type.
Un pilote peut se cadrer par les preuves attendues
Pour éviter qu’une démonstration ne repose seulement sur des alertes convaincantes, écrivez avant l’essai les critères qui distingueront une piste d’un constat. Ce cadrage peut tenir en quelques décisions :
- Délimiter les cibles. Nommer les applications et environnements autorisés, les comptes de test et les actions exclues.
- Définir le seuil de confirmation. Pour chaque classe de vulnérabilité visée, demander quelle reproduction observable est considérée comme probante.
- Prévoir le traitement des candidats. Décider où seront conservées les pistes non validées, qui pourra les examiner et à quelles conditions elles seront réévaluées.
- Rendre les limites lisibles. Lister les types de failles et scénarios que les validateurs ne couvrent pas, plutôt que de résumer le résultat par un seul nombre de découvertes.
- Organiser la remise aux équipes. Exiger pour chaque constat la cible, les conditions de reproduction, le résultat observé et les éléments permettant à l’équipe de vérifier le correctif.
Cette grille ne promet pas qu’un agent trouvera une faille ni qu’il couvrira un périmètre donné. Elle transforme plutôt l’essai en décision vérifiable : les livrables attendus et les limites sont posés avant que les résultats ne soient interprétés.
Pour comparer le dispositif à une prestation de revue de code ou de test d’intrusion, il est utile de choisir le niveau de preuve d’un audit de sécurité applicative selon le risque et les questions auxquelles l’entreprise doit répondre.
Automatiser le correctif est une autre décision
InfoQ indique que Google travaille à l’intégration de PageBreak avec d’autres initiatives de sécurité agentique, dont CodeMender, dans l’objectif à plus long terme de réduire l’intervention des équipes produit à la validation de correctifs générés par l’IA. Cette orientation ne signifie pas que le correctif automatique est déjà établi comme résultat du dispositif décrit. Détecter, reproduire, proposer une correction et accepter son déploiement sont des décisions distinctes.
Pour une entreprise, le principe à retenir est simple : ne pas confondre autonomie de recherche et autonomie d’action. La valeur d’un agent de sécurité dépend autant de la preuve qui accompagne ses constats que des limites explicites de ses validateurs et du rôle laissé aux équipes qui corrigent. C’est ce cadre, plus que le seul volume annoncé, qui permet de décider si un pilote répond à un besoin réel.
Discussion
Vos retours sur cet article
Partagez une expérience ou posez une question utile aux autres lecteurs. Chaque message est relu avant publication.
Ajouter un commentaire
Votre adresse e-mail reste privée.