Une mise en production peut réussir techniquement et dégrader malgré tout un usage essentiel : une remise qui ne s’applique plus, un export comptable incomplet, un statut client mal recalculé, une recherche devenue trop lente. La recette de non-régression sert à vérifier que les fonctions déjà utiles continuent de fonctionner après un changement logiciel.
Le sujet paraît souvent évident jusqu’au moment où il faut choisir ce qui sera testé. Une PME n’a généralement ni le temps ni le budget pour rejouer toute l’application à chaque livraison. Le bon cadrage consiste donc à identifier les parcours qui portent le plus de risque métier, à fixer des critères vérifiables et à laisser une preuve exploitable après la décision de mise en production.
Étape 1 : partir des usages qui ne doivent pas casser
Une non-régression ne commence pas par une liste d’écrans. Elle commence par les usages qui doivent rester fiables après la livraison : créer une commande, modifier une adresse, valider une intervention, éditer une facture, alimenter un reporting, synchroniser un outil tiers. Le vocabulaire doit rester métier, même si l’équipe technique prépare ensuite les jeux de données et les contrôles.
Cette approche évite deux dérives fréquentes. La première consiste à tester uniquement la nouveauté et à oublier les fonctions anciennes qui dépendent du même code. La seconde consiste à demander aux utilisateurs de tout vérifier sans priorité claire. Dans les deux cas, la recette produit beaucoup d’effort, mais peu de décision.
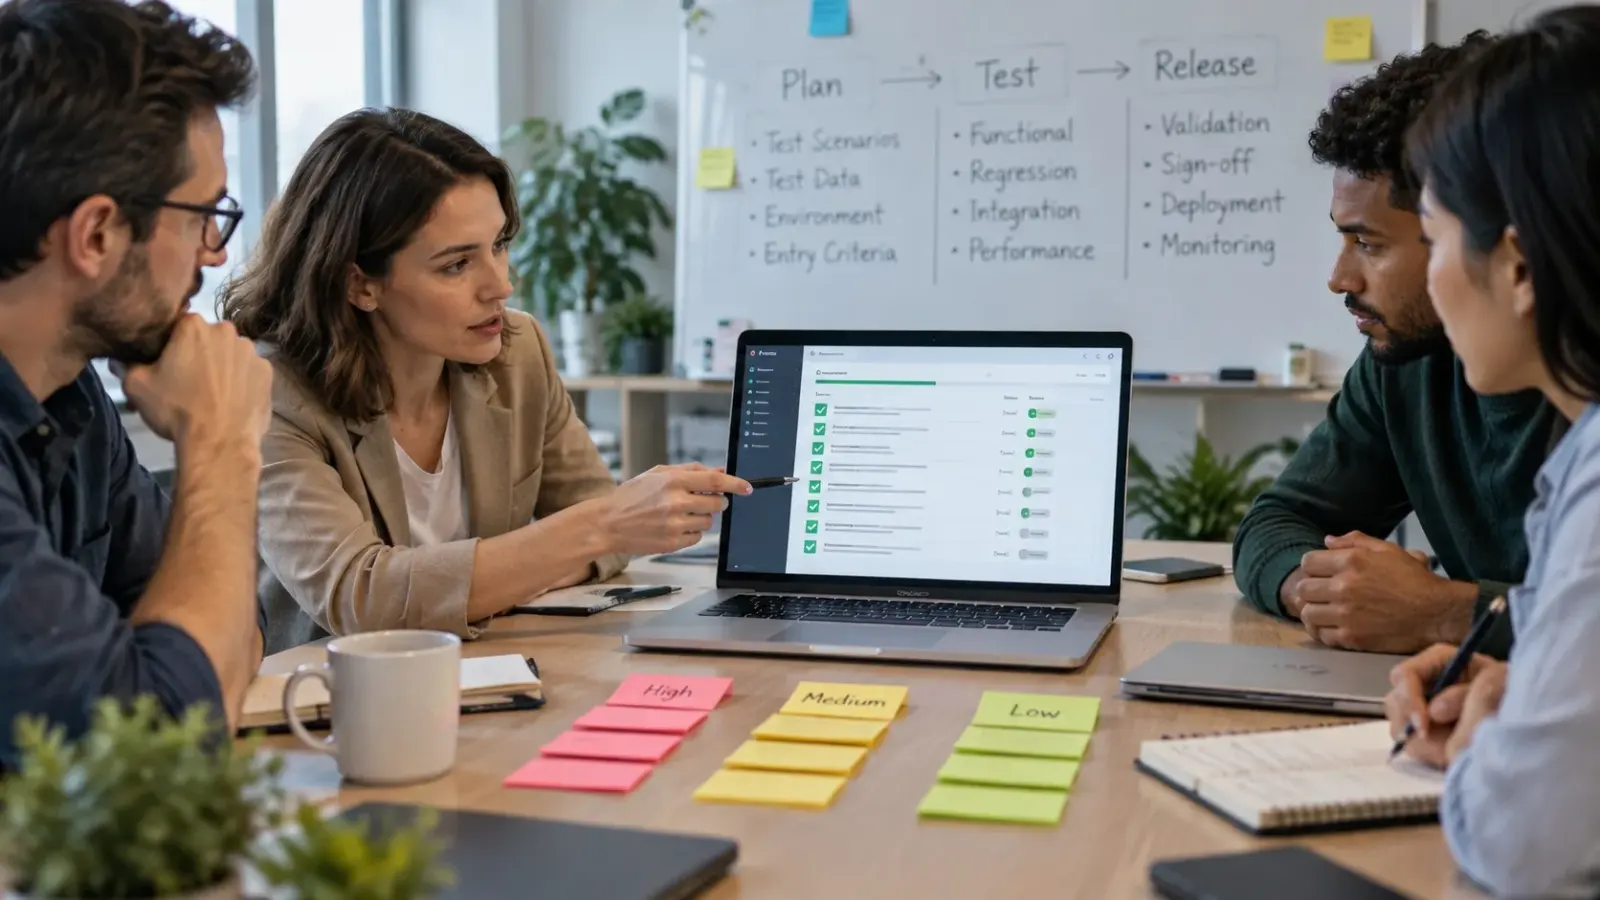
Étape 2 : classer les scénarios selon leur risque
Le classement doit tenir compte de l’impact métier, de la fréquence d’usage, des dépendances techniques et de la difficulté à corriger après coup. Un écran rarement utilisé peut devenir prioritaire s’il déclenche un flux de facturation ou s’il modifie une donnée de référence. À l’inverse, un parcours très visible peut être moins risqué si l’erreur est immédiatement réversible.
| Critère | Question à poser | Preuve attendue |
|---|---|---|
| Impact métier | Que se passe-t-il si le scénario échoue après la mise en production ? | Décision de criticité validée par le métier |
| Dépendance | Le scénario appelle-t-il une API, un export, un traitement différé ou un outil SaaS ? | Flux concernés listés avec responsable |
| Réversibilité | Peut-on corriger l’erreur sans reprise lourde des données ? | Chemin de correction ou de retour arrière décrit |
| Observabilité | Saura-t-on constater l’échec rapidement ? | Message, log, alerte ou contrôle fonctionnel identifié |
Étape 3 : écrire des scénarios courts et décidables
Un scénario de recette utile tient en quelques lignes : contexte, action, résultat attendu, donnée utilisée, rôle utilisateur et critère de décision. Il ne doit pas ressembler à une procédure complète de formation. Son rôle est de dire si l’application peut être livrée, pas d’apprendre le métier à un nouvel arrivant.
Par exemple, au lieu d’écrire “tester la création client”, il vaut mieux formuler : “un gestionnaire crée un client professionnel avec deux adresses, un SIRET renseigné et une condition de règlement spécifique ; le client est visible dans le CRM et repris dans l’export de facturation du soir”. Cette formulation rend visibles les dépendances et les preuves.
Étape 4 : répartir ce qui relève du métier, de l’IT et du prestataire
La non-régression échoue souvent parce que chacun croit que l’autre vérifiera le point critique. Le métier connaît les cas limites et les règles implicites. L’équipe IT connaît les interfaces, les comptes, les environnements et les contraintes d’exploitation. Le prestataire connaît le changement livré et les zones de code touchées.
La responsabilité doit donc être explicite. Le métier valide le résultat attendu et arbitre la criticité. L’IT prépare l’environnement, les accès, les données et la preuve de passage. Le prestataire signale les impacts probables, automatise ce qui peut l’être et documente les limites de la couverture de test.
Étape 5 : choisir ce qui doit être automatisé
Automatiser toute la recette n’est pas toujours réaliste. Les bons candidats sont les scénarios fréquents, stables, coûteux à rejouer manuellement et faciles à vérifier par un résultat clair. Les contrôles de calcul, les API, les exports structurés et les règles de droits se prêtent souvent mieux à l’automatisation qu’un parcours très exploratoire.
L’automatisation doit rester lisible pour la décision. Un tableau de tests verts ne suffit pas si personne ne sait quels risques sont couverts. À chaque script ou test automatisé doivent correspondre un scénario métier, un propriétaire et une règle d’échec : bloquant, à analyser, ou accepté temporairement avec justification.
Étape 6 : organiser la chronologie avant le jour J
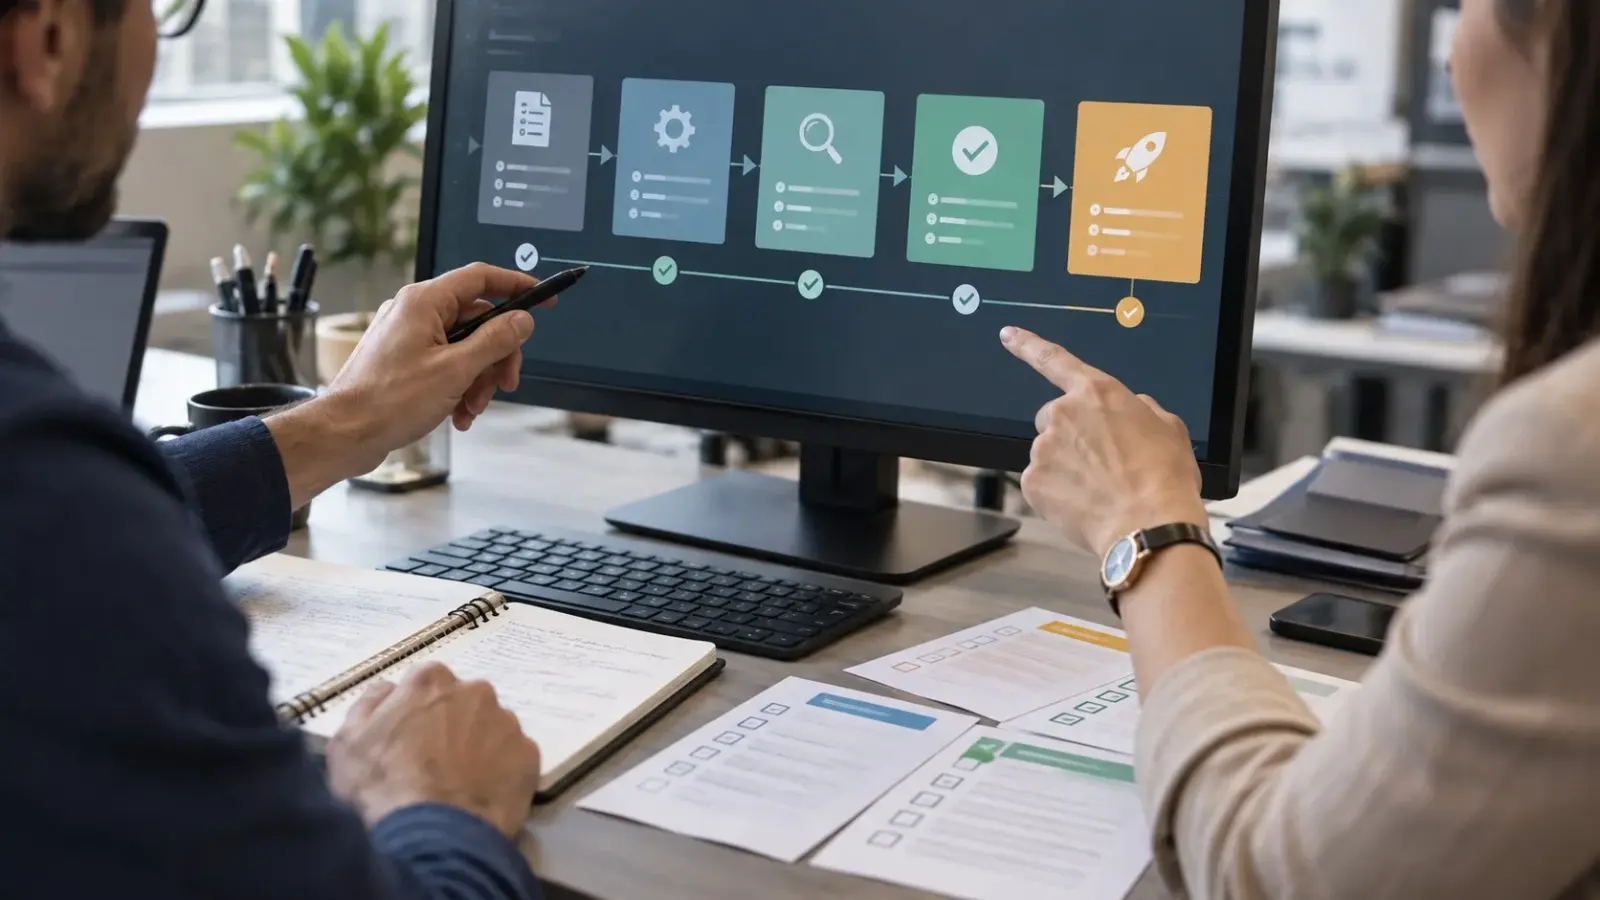
La chronologie évite de découvrir trop tard qu’un compte manque, qu’un export n’est disponible que le lendemain ou qu’un traitement nocturne doit être observé avant décision. Elle doit être courte, mais précise.
- Avant développement : lister les parcours critiques et les dépendances touchées.
- Avant recette : préparer les données, les rôles, les comptes et les critères de succès.
- Pendant recette : exécuter les scénarios prioritaires, noter les écarts et qualifier leur impact.
- Avant mise en production : décider des anomalies bloquantes, des contournements acceptés et du plan de surveillance.
- Après mise en production : vérifier les parcours critiques réels et conserver la preuve de contrôle.
Étape 7 : relier la non-régression à la mise en production
Une recette de non-régression n’a de valeur que si elle influence réellement la décision de mise en production. Les anomalies doivent donc être classées avant le jour J : ce qui bloque, ce qui peut attendre, ce qui nécessite une communication support et ce qui impose une surveillance renforcée.
Cette étape rejoint directement la préparation d’une mise en production sensible. Les critères de bascule, de retour arrière et de support doivent s’appuyer sur des scénarios vérifiés, pas sur une impression générale de stabilité.
Checklist des livrables à demander
- Une liste courte des parcours métier critiques, validée par un responsable métier.
- Un tableau de scénarios avec résultat attendu, donnée utilisée, rôle et niveau de criticité.
- La liste des dépendances concernées : API, exports, traitements différés, droits, reporting.
- Une règle de décision pour les anomalies bloquantes et non bloquantes.
- Un compte rendu de passage indiquant ce qui a été testé, ce qui ne l’a pas été et pourquoi.
- Les preuves utiles après livraison : captures si nécessaires, logs applicatifs, export de résultat ou rapport de tests automatisés.
Le point de vigilance : ne pas confondre couverture et confiance
Une recette longue peut donner confiance sans couvrir les risques importants. Une recette courte peut être suffisante si elle cible les bons parcours et si les limites sont connues. Le décideur doit donc demander moins une quantité de tests qu’une justification claire : pourquoi ces scénarios, pourquoi ce niveau d’automatisation, pourquoi cette anomalie est-elle acceptable ou non ?
La qualité logicielle devient alors un outil de pilotage. Elle ne se limite pas à détecter des défauts ; elle aide à décider si le changement peut entrer en production avec des risques compris, des responsabilités visibles et des preuves conservées.
Discussion
Vos retours sur cet article
Partagez une expérience ou posez une question utile aux autres lecteurs. Chaque message est relu avant publication.
Ajouter un commentaire
Votre adresse e-mail reste privée.